5000词需求文档,Claude也只能交付14%,实测28种Agent组合

LoLBench把社区功能提案和对应的已合并PR,改造成100道长程代码任务。每道题只给Agent一份平均约5000个英文单词的提案,以及实现前的代码仓,要求它自行推导修改范围、完成跨文件实现,并通过测试验证。评测在断网Docker环境里进行,防止Agent检索上游实现。这套设计把“读需求、找代码、改系统、保回归”串成一条完整交付链,也让28种Agent组合的真实上限暴露出来。
五千词提案成了Agent的第一道关
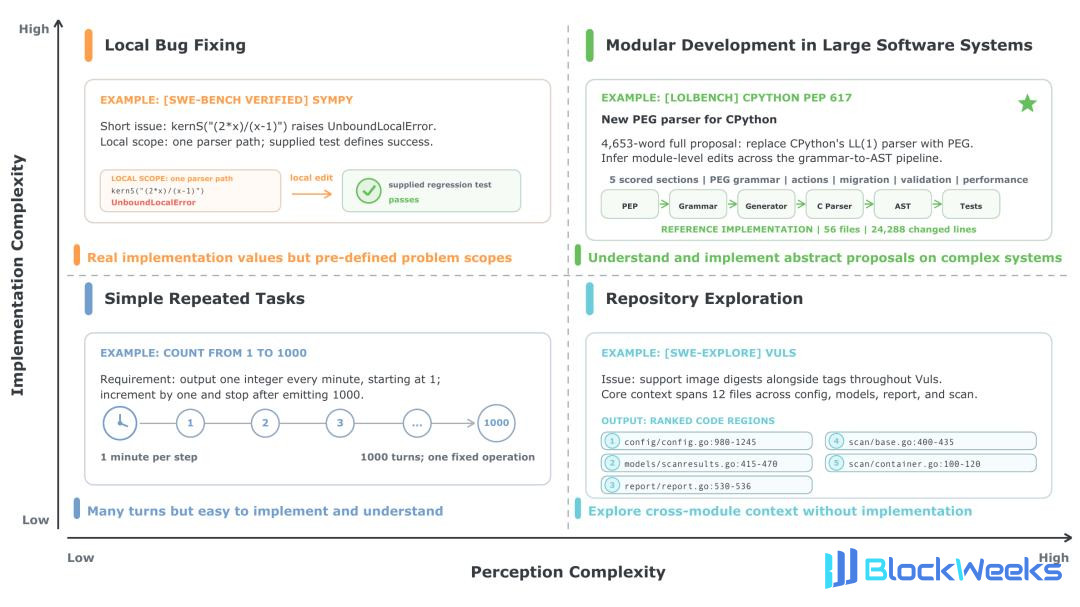
LoLBench覆盖29个系统、8种语言和5个领域,任务来自真实功能提案与已合并PR。它同时考察两类复杂性:感知复杂性,是读懂提案、识别隐含约束和跨模块依赖、推导修改范围与实现规范的难度;实现复杂性,是把规范转成正确的跨文件修改,并通过测试和修复避免已有功能被破坏的难度。
评测没有只看“最后能不能跑”,而是用两类测试验证交付正确性:
- 新增功能测试(F2P)要求实现前失败、实现后通过,通过公开接口检验行为,允许不同内部实现。
- 回归测试(P2P)要求实现前后均通过,防止新功能破坏旧行为。
研究团队还在项目原有测试基础上构造遗漏功能、篡改需求等错误实现作为变异体,补充测试用例识别漏检错误,并提高参考补丁的测试覆盖率。增强后,1688个变异体的检出率从约61%升至96%,F2P按任务平均的行覆盖率从约60%升至79%。这意味着“交付”不是代码写完就结束,而是新增行为正确、旧行为不坏、测试能抓住错误实现。
28种组合只有14%撞线
研究团队评估了6个前沿模型与5个脚手架的28个可用组合,单任务限时6小时。Opus 5搭配Claude Code或mini-SWE-agent均以14%的解决率并列最高,全部组合的中位数仅2%。也就是说,一半左右的组合只能解决极少数任务,最高组合也仍有86%的任务没有完成。
更值得关注的是成本与产出的错位。同样使用Opus 5,mini-SWE-agent与Claude Code解决率相同,但前者耗时为后者的3.2倍、生成Token为5倍。更多交互和更多Token,并没有换来更高解决率。
Token和交互轮数还集中暴露了瓶颈所在:按Agent平均,定位阶段占非缓存输入Token的52.4%、生成Token的45.4%,交互轮数也显著多于其他阶段。对照参考实现修改的既有文件和函数,全部28组Agent的文件修改精确率为38.0%至80.4%,召回率为30.3%至65.0%;函数修改精确率为54.2%至65.6%,召回率为20.8%至53.4%。代码定位准确率低、覆盖不完整,后续实现自然容易跑偏。
修改树和API规范把分数抬到34%
研究团队保留原功能提案,额外提供参考实现导出的修改文件树与API实现规范,帮助Agent确定修改范围。补充修改指引后,Opus 5+Claude Code的解决率从14%升至34%,GPT-5.6 Sol+Codex从3%升至25%,DeepSeek V4 Flash+OpenCode从1%升至17%。
这组数据说明,感知负担确实可以缓解:告诉Agent“改哪些文件、接口长什么样”,能明显减少它在需求理解和代码定位上的消耗。但最佳组合仍有66%的任务未解决。Agent还要协调模块、实现接口、通过测试并避免回归,大型系统的实现复杂性依然很高。修改树和API规范能帮Agent少走弯路,却不能替它完成跨文件工程交付。
多Agent并行先算清Token和协调账
另一条产品路线正在把Agent数量堆得
