Anthropic招股书揭示大模型六趋势

当地时间10月26日,Claude开发商Anthropic正式披露IPO招股文件,计划以“ANT”为股票代码登陆纳斯达克。这家成立仅五年的AI公司,把收入怎么来、算力花在哪、模型怎么迭代、组织怎么运转、风险怎么定价,第一次完整摆到了公开市场面前。招股书显示,Anthropic今年上半年实现营收约163亿美元,超过2025年全年46亿美元的收入;同期净亏损高达807亿美元,但巨额亏损主要来自金融工具估值变化等非现金费用,实际经营状况正在改善。市场预计其上市估值可能达到1.5万亿至2万亿美元,而今年5月公司估值约为9650亿美元。把四百多页招股书、15页路演投资者材料、41分钟路演视频和七位创始人联名公开信放在一起读,大模型行业正在发生的六个变化,已经很难被一句“模型公司只会烧钱”概括。
Anthropic把四百页招股书摊开:半年163亿美元收入与807亿美元账面亏损同框
Anthropic的财务曲线呈现出典型的前沿模型公司特征:收入爬坡极快,投入同样惊人。营业收入从2023年的4100万美元,增至2024年的3.86亿美元,2025年又跃升至45.85亿美元;到了2026年,仅上半年就实现162.86亿美元收入。从2025年到2026年中,季度收入同比增长均在15倍左右,公司也明确表示当前高增速可能很难维持。
更值得关注的是收入结构和效率指标:
- 2026年上半年162.86亿美元收入中,按调用量计费的收入约131亿美元,占八成;企业版、Pro/Max等订阅收入32亿美元,占两成。
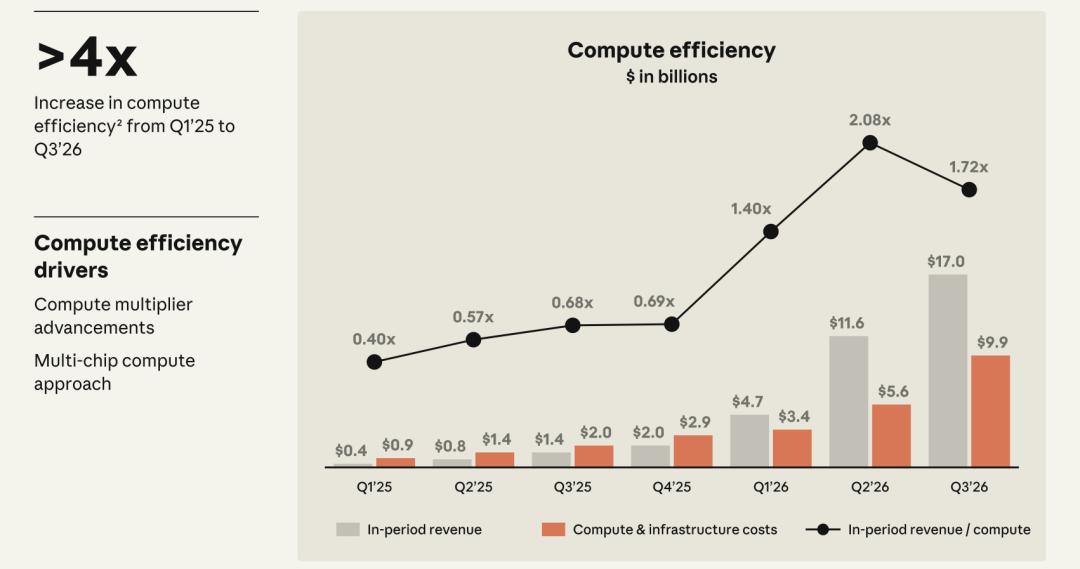
- 每1美元收入与算力投入之比,从1:2.5提效至1:0.5。
- 当前净收入留存率达到900%,并且没有收入占比超过10%的头部客户。
- 直接服务成本被收入覆盖,毛利快速改善,经营现金流开始转正。
这意味着,Anthropic的生意说穿了就是按token卖“智能”。同一版模型训练完成后,服务第一位客户和第一亿位客户,不需要把训练重新做一遍;推理仍消耗算力,但前期研发投入可以由更多使用量分摊。只要用量增长足以抵消降价,收入就能继续增长;如果单位服务成本下降得比价格更快,毛利率也会提高。不过,招股书还没有证明,公司能够在持续开发下一代模型、兑现长期算力承诺之后,稳定地留下可供股东支配的现金。
规模定律没有失效,研发主引擎换成了自家模型
Anthropic创始团队里,有2020年那篇《神经语言模型的规模定律》的主要作者。创始人信里说,当时很多人不相信机器智能会这么强烈地依赖规模,但基于规模定律做出的预测,一次又一次被证明是对的。招股书的判断也很明确:AI能力还会持续进步,在可预见的未来,需求会持续超过供给,而供给主要受算力约束。
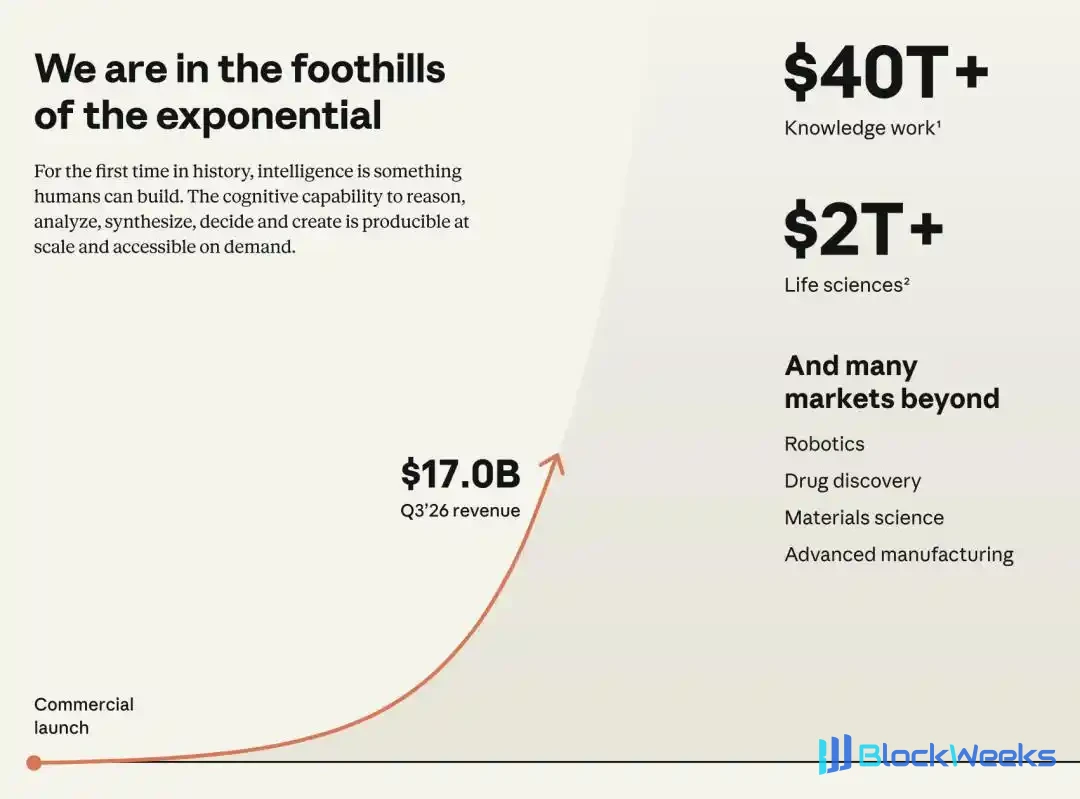
但比规模定律本身更值得注意的,是研发方式的变化。大模型竞争制胜的重点,正转向比研发循环的转速。谁的模型最先能把自家公司的活干好,谁的下一代模型就来得更快。可验证的领域会最先被攻克,也会最先反哺研发。Anthropic的闭环说明,内部使用的深度比外部榜单的排名更能决定迭代速度:先从代码这类结果可验证的领域切入,让模型先改造自己的研发流程,再把这套能力外溢给客户。
这条循环也有另一面。招股书专门提到,用AI加速AI会带来相当大的安全风险,公司的负责任扩展政策里已经写入了接近递归自我改进时的监测和缓解计划。创始人信说得更直接:必要时,公司可能会主动放慢速度。规模定律仍然有效,但研发的主引擎正在换人——从单纯堆人、堆数据、堆算力,转向让AI自己参与下一轮模型的研发循环。
聊天框退场,虚拟协作者开始接管工作流
创始人信里有一段对产品代际的判断:AI聊天机器人大约在2022年变得可用,AI编程智能体大约在2025年,面向通用知识工作和科学发现的智能体在2026年逐步变得可用。信里还说,Anthropic会花更少精力去巩固现有产品,花更多精力去定义新产品,因为新一代模型总在打开几个月前还不可行的产品类别。
招股书给这一代产品起了个名字,叫“虚拟协作者”:拥有组织授予的权限、系统连接和上下文,能使用内部工具,能执行跨越多个步骤、需要持续推理的工作流程,与员工并肩工作。这与此前“你问一句、它答一句”的聊天框已经是两种产品逻辑。
产品设计也随之变化:
- 模型、运行框架、连接协议、技能包要一起做,围绕交付结果而不是回答质量来设计产品。
- 要围绕模型半年后的能力来规划产品,而不是只盯着当前能力。
- 企业服务拼的是交付体系,包括开发者自下而上的渗透、应用AI团队的深度交付、云平台和集成商的生态覆盖、FDE工程师认证与培训,以及面向中型企业的服务形态。
模型能力过剩的时候,谁能把能力变成客户流程里的结果,谁就能拿到收入。产品从对话框走向虚拟协作者,交付的是工作,而不是回答。
智能量产的分岔口:基础能力像水电,前沿能力像奢侈品
Anthropic的报表把大模型商业模式的三个问题摆到了台面上:训练大模型能不能挣钱?为了继续卖智能,每年还要投进去多少钱?赚到的钱,能不能长期留在模型公司手里?
从按token计费加持续降价的模式看,前提是单任务成本持续下降。没有效率提升支撑的降价,只是补贴;有效率提升支撑的降价,才能换来需求弹性。因此,把单位算力产出当作第一经营指标,可能比单纯追求榜单排名更接近生意的本质。
往后看,大模型竞争的终局很可能出现两种生意:基础智能越来越像公用事业,前沿智能则越来越像“奢侈品”。随着技术进步,只要越来越多的模型跨过了日常工作的能力门槛,价格竞争就会变得激烈。整理会议记录、给商品分类、写一封通知、从表格里找出异常——现实世界里,大量工作需要的不是多么聪明,而是准确、稳定、便宜。当几家模型都能把同一件事做好,客户自然会开始比价。到了这一步,基础智能就会越来越接近水、电、通信这样的服务:随时可用,按需购买,供应商靠成本、规模和服务质量竞争。智能成为基础设施,也可能意味着它更不可或缺,却更难卖出高价。
1.5万亿至2万亿美元预期下,模型厂商的估值锚被重新校准
Anthropic当前ARR据最新报道处于650亿至750亿美元水平,对应1.5万亿至2万亿美元市值预期,估值倍数在20至25倍。这样一份数据在投资人眼中既是指引也是压力。长期来看,如果Anthropic能够按照当前预期成功上市,有可能引导模型厂商重新校准一轮市值或估值。
公开财务数据后,国内模型厂商的估值坐标也被拿来对照。根据最新财报及股价数据,智谱当前市值与ARR之比在20倍水平,MiniMax则在10倍水平。有长期关注AI领域的投资人认为,智谱和MiniMax长期有可能迎来市值调整,但模型表现仍是重中之重:GLM-5系列在AI Coding上为智谱打开了企业API市场,并扭转收入结构;MiniMax今年凭借H3开源,在视频模型领域赢得与字节Seedance对垒的机会,后续M3 Pro还肩负弥补文本模型差距的使命。
仍处于一级市场的Kimi和DeepSeek,估值似乎偏高。最新消息显示,Kimi Pre-IPO轮投前估值为500亿美元,ARR水平据传在10亿至20亿美元;DeepSeek最新一轮融资估值5000亿人民币,有报道称其ARR已达10亿美元。有投资人与AI行业开发者交流密切,其体感是在这个群体中,使用Kimi和DeepSeek模型的开发者占比极高,明显超越国内其他模型厂商。市场短期看情绪,长期还是要依靠技术。“这两家大模型有大量真实用户,在模型表现上还能跟海外一战。”他说,“失去真实用户的模型厂商,才会比较危险。”
就Anthropic的市值预期而言,不同投资人均认为,如果没有意外宏观因素出现,其上市初期达成1.5万亿至2万亿美元不难,短期会迎来一定幅度上涨,但随后大概率迎来一波下跌——而这似乎是包括大模型、具身智能在内的AI领域头部公司们的普遍命运。对模型厂商来说,招股书打开的不仅是一份财务报表,更是一把新的估值尺子:收入增速、单位算力产出、客户留存、交付体系与模型代际,正在共同决定智能量产时代谁能在牌桌上留到最后。
