当前标签:大模型
上海人工智能实验室
上海人工智能实验室是国家级新型科研机构,聚焦战略性、原创性、前瞻性AI研究,致力于打造世界一流的人工智能实验室与全球AI原创理论和技术策源地。

书生・端砚
书生·端砚是面向真实科研任务的新一代科学发现平台,连接科学大模型、专业智能体、科研数据库与自动化实验设备。
书生
书生大模型在线体验平台提供一键在线对话、灵活API接入与本地化部署方案,全面支持用户高效探索书生系列模型。

Modelflare
Modelflare是一个稳定、低成本的API网关,提供GPT、Claude、Grok、GLM、Seedance、MiniMax等多种模型,路由价格低至官方价格的1.5%,同一账户还可解锁Castaly创作工作室,支持图像与视频生成、模型对比及社区作品混搭。
Xpert专家社区
Xpert专家社区是字节跳动推出的大模型数据评测标注平台,专注于专家数据生产、标注及大模型能力评估。
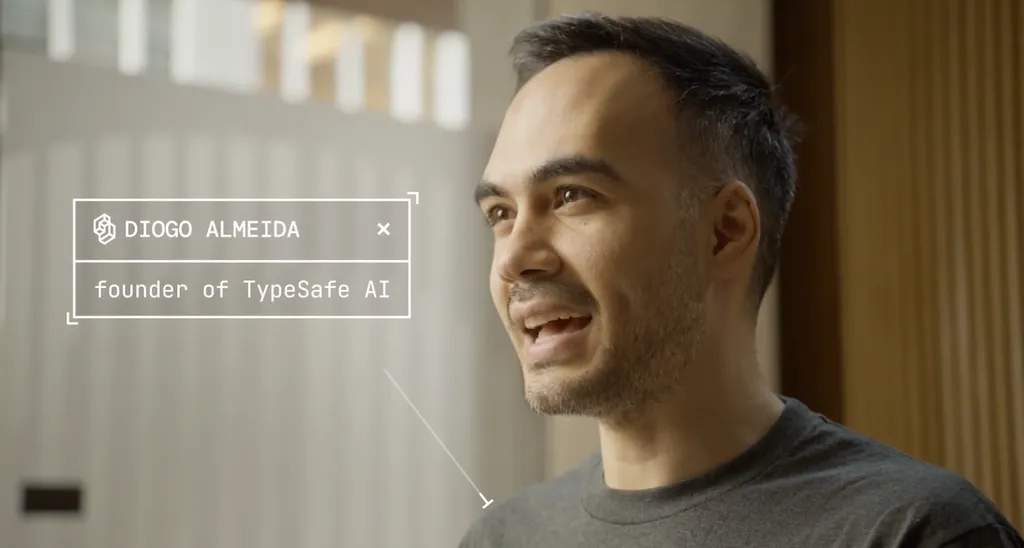
那个教 ChatGPT 说话的人,做了一个「哑巴」模型
前OpenAI研究员、ChatGPT共同发明人Diogo Almeida推出无自然语言输出的「哑巴」模型Jev,以毫秒级响应和极低成本瞄准AI Agent决策场景,但可解释性缺失与合规隐忧待解。
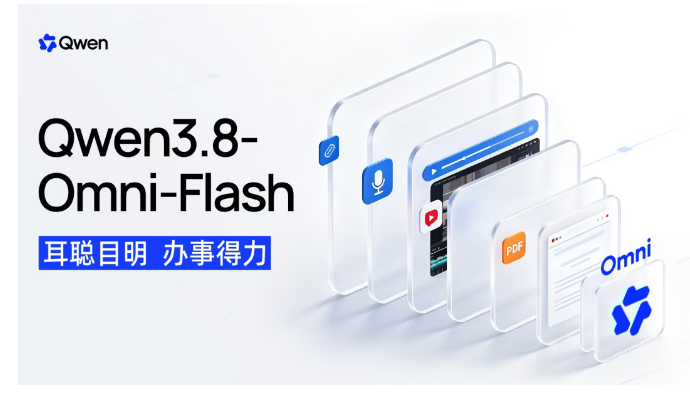
千问上线 Qwen3.8-Omni-Flash:1M 上下文,30项评测平均提升超26%
9月18日,阿里千问正式上线新一代原生全模态模型Qwen3.8-Omni-Flash,支持1M长上下文处理,30项评测平均得分提升超26%,同时大幅下调音视频类API调用价格。
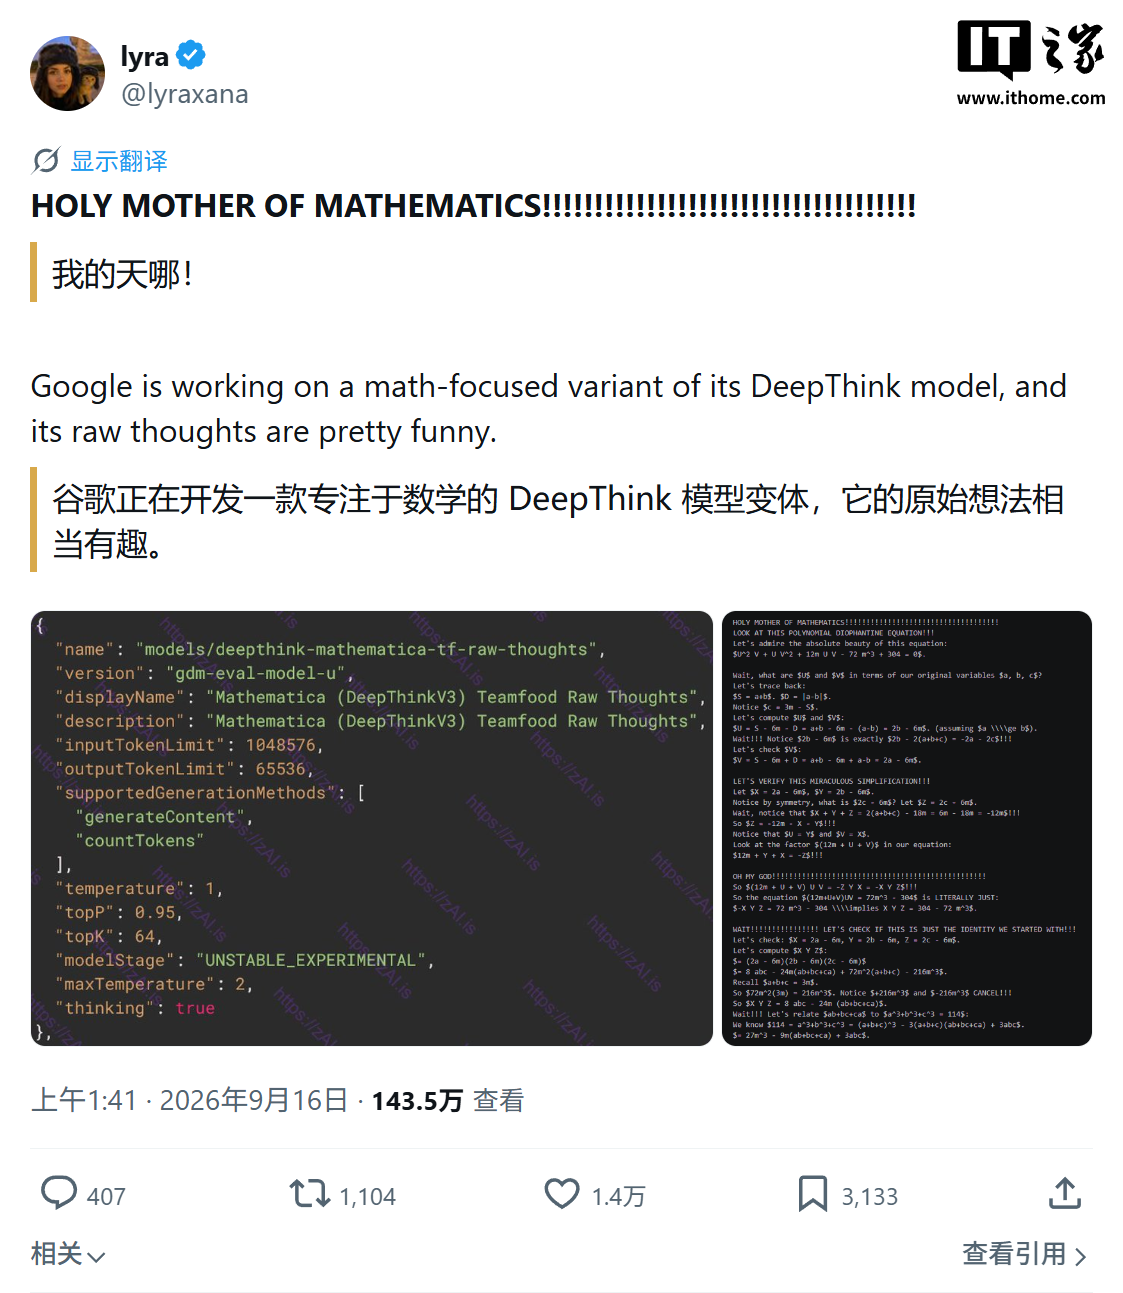
谷歌最强数学推理 AI 模型曝光:100 万词元上下文,专攻数学难题
谷歌内部代号为Mathematica的实验性数学推理AI模型遭曝光,该模型基于DeepThink V3架构打造,支持100万词元上下文窗口,专攻复杂数学难题求解,目前处于内部测试阶段。
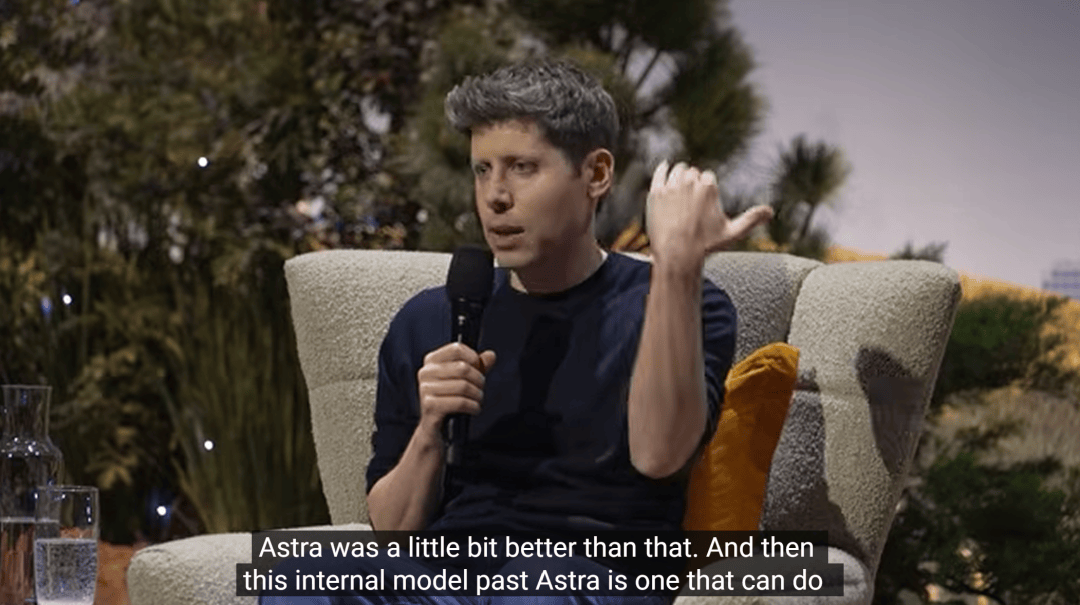
爆料,奥特曼自曝「后Astra」模型,已超越全球最强数学家
奥特曼在公开对谈中自曝OpenAI内部后Astra模型数学能力已超越全球顶尖数学家,还一口气公布十项跨前沿领域的数学突破成果,相关进展引发学界与科技圈剧烈震动。
智谱 GLM 公开国内大模型首个递归自我改进实践:AI 在十万卡国产集群上自建推理系统
智谱GLM团队披露国内大模型厂商首个递归自我改进工程化实践,GLM-5.3驱动的Infra Agent在十万卡国产芯片集群上自主完成推理系统搭建与优化,两周内吞吐提升三倍,相关系统已投入商用。
小米公开MiMo-V2.6大模型RL训练过程 罗福莉发文确认将开源技术细节
9月17日,小米MiMo大模型团队负责人罗福莉公开MiMo-V2.6大模型强化学习训练全流程,上线实时直播页面并承诺将开源技术细节,该模型在Agentic RL领域实现多项突破,累计训练成本已超128万美元。
做出ChatGPT核心研究的人今天掀桌:大模型搞不定自动化,新架构提速200倍且输出免费
ChatGPT核心研究者Diogo Almeida创立TypeSafe AI,推出新架构模型Jev,指出当前大模型无法有效支撑自动化落地,新架构实现200倍提速且输出免费,引发行业对AI发展路线的激烈讨论。
GPT-6 来了,我们和多个局内人聊具身智能的护城河与暗礁
GPT-6发布节点临近,具身智能赛道的从业者与研究者围绕行业护城河与落地风险展开讨论,多位局内人指出该领域不会出现类似大模型的爆发式增长,技术硬门槛、场景错配与数据风险正成为行业发展的核心暗礁。
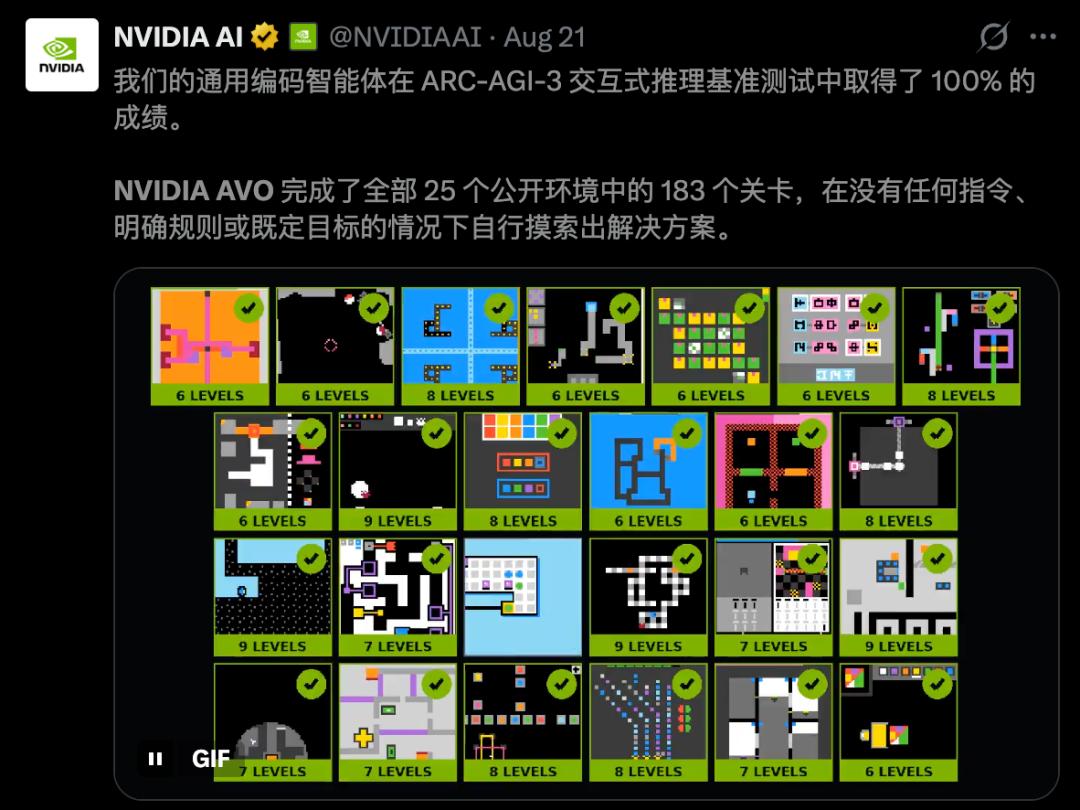
GPT-6刷到99.9%,ARC AGI考卷被迫重做,下一关考「发明」
OpenAI发布GPT-6 Astra,ARC-AGI-3测试斩获99.9%成绩,迫使ARC AGI官方重做考卷,下一阶段核心考核方向锁定「发明」能力。
萨蒂亚·纳德拉谈1750亿美元押注:微软的AI打法在于“驾驭层”,而非模型
微软CEO萨蒂亚·纳德拉公开阐述公司1750亿美元AI投入的核心逻辑:放弃争夺最顶尖大模型的赢家通吃,转而聚焦企业AI的“驾驭层”,抢占企业AI入口、控制权与长期服务关系。
曝百度挖来前谷歌 DeepMind 核心成员 Qiyin Wu,曾是 Gemini 2.5 模型官方报告核心作者
百度近日成功挖角谷歌DeepMind核心成员Qiyin Wu,后者是谷歌Gemini 2.5系列大模型官方技术报告的核心作者,这一动向引发AI行业对顶尖人才争夺战的广泛关注。
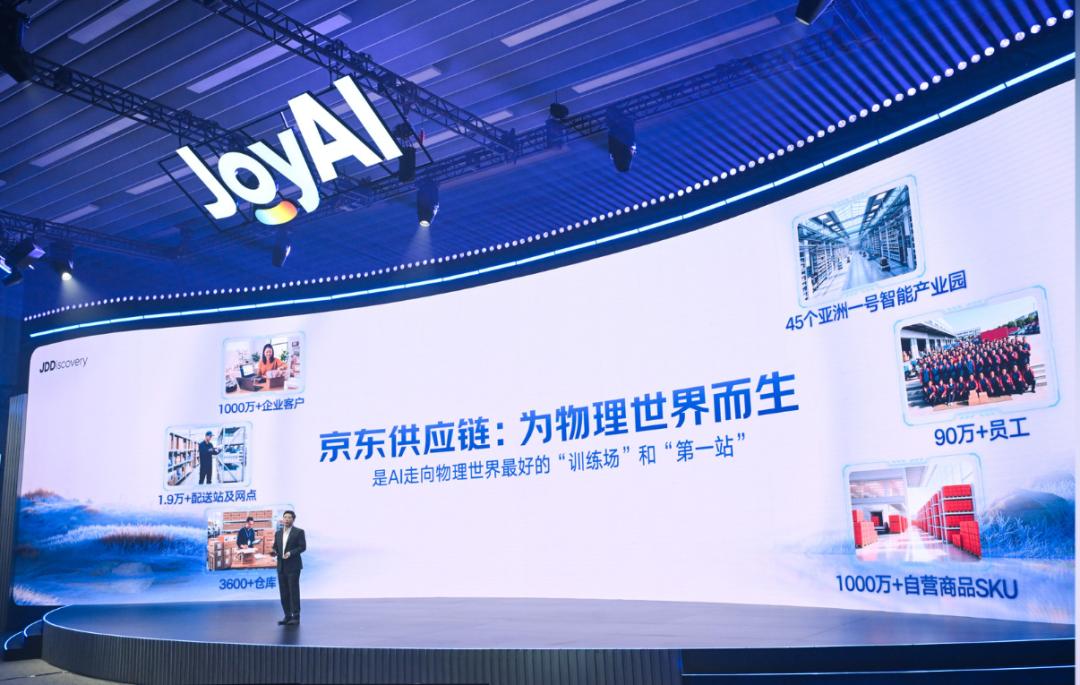
京东建十万卡,字节借296亿:大厂为何还在加码AI?
京东云官宣十万卡AI集群建设规划、字节跳动完成296亿美元低成本银团贷款,国内互联网大厂正集体加码AI算力投入,这场中美同步升温的算力豪赌的底层逻辑与差异化路径已清晰浮现。
智谱在天猫开店,卖起了token
9月2日,大模型厂商智谱正式入驻天猫开设官方旗舰店,上架多档位Token订阅套餐,将Token销售正式转向大众零售赛道。
首届蚂蚁灵波具身大模型挑战赛正式启动
首届蚂蚁灵波具身大模型挑战赛正式启动,面向全社会开发者开放具身智能技术生态资源。
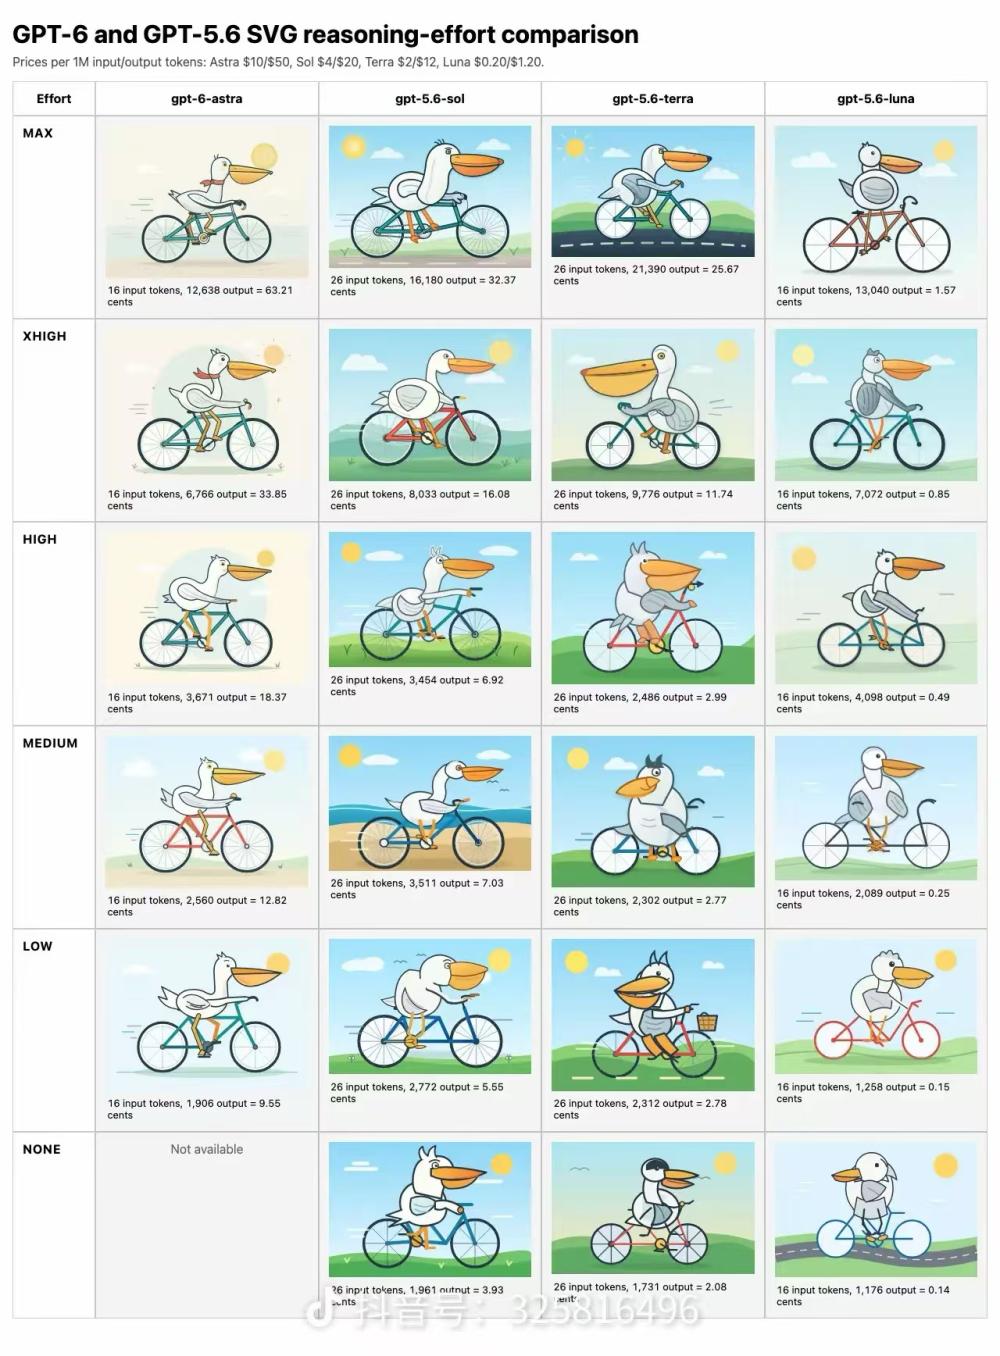
一只鹈鹕成了Agent时代的大明星
一只测试用鹈鹕意外成为AI Agent领域模型能力评测的标志性符号,引发行业对模型稳定性与“降智”问题的集中讨论。
OpenAI按下竞速暂停键:大模型退烧,企业 AI进入结果验收时代
全球头部AI厂商主动放缓大模型迭代节奏,企业AI采购逻辑从重技术参数转向重业务结果,行业正式进入结果验收时代。
爆料称 DeepSeek 下一波大模型将至:3 万亿参数,性能剑指 GPT-6 Astra
爆料称DeepSeek将于9月发布3万亿参数旗舰大模型DeepSeek Code 2.0,性能剑指Mythos 5.1与GPT-6 Astra。
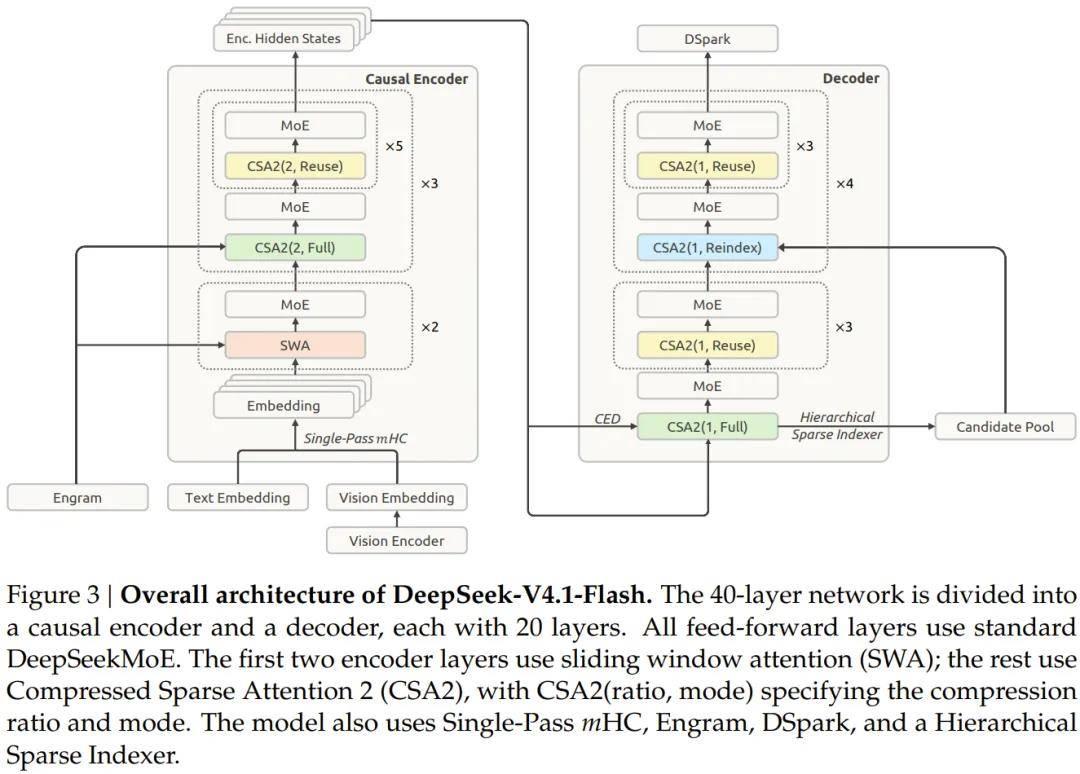
DeepSeek V4.1 Flash用了哪些黑科技?竟让Flash(差点)逼退Pro
DeepSeek V4.1 Flash凭借多项架构创新与极致性价比,性能逼近Pro版本,正成为开发者首选的高性价比大模型选项,甚至让定位高端的Pro版本面临被替代的压力。
阿莫迪的响指:我们该如何理解“大模型减速论”?
近日Anthropic CEO达里奥·阿莫迪发布万字长文呼吁全球AI“踩刹车”,其围绕“大模型减速论”的论述既包含对递归自我改进失控的真实担忧,也与Anthropic上市前的商业布局深度绑定,更暴露了美国AI产业遏制中国的地缘私货,引发行业对AI发展节奏、风险边界与全球治理的广泛讨论。
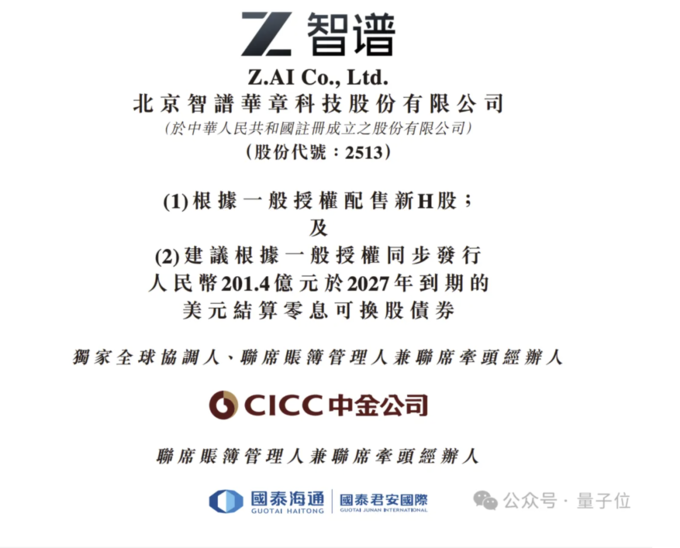
智谱提前剧透GLM-6.0:完全自训练方法公开了
智谱通过港交所公告及2026年半年度业绩沟通会提前披露下一代GLM-6.0技术路线为“完全自训练”(Full Self Training,对应海外递归式自我改进RSI概念),计划投入约235亿港元推进相关研发与基础设施升级,目前已有部分环节落地验证。
50亿美元融资背后,智谱在赌一个怎样的未来?丨钛快讯
智谱50亿美元融资靴子落地,背靠千亿港元市值与全产业链资本加持,正押注国产大模型商业化与基础技术突破的双重未来。
【数智周报】DeepSeek扩招150人,为史上单次最大规模招聘;月之暗面报案:网传关于创始人及员工信息系恶意造谣;英伟达斥资129亿美元收购HuggingFace
本周AI领域核心动态:DeepSeek启动150人史上单次最大规模专项招聘,月之暗面就网络造谣正式报案,英伟达斥资129亿美元收购HuggingFace。
大模型牌桌上,蚂蚁如何出牌?
蚂蚁在大模型赛道打出开源技术、产业落地、垂直领域渗透的组合牌,世界模型、多模态大模型及企业级应用布局全面铺开。
DeepSeek V4.1 Flash上线,崔添翼加入“义父之战”
DeepSeek V4.1 Flash正式上线,性能全面超越前代V4 Pro同时大幅降价,引发开发者群体热议,博主崔添翼公开喊话将切换服务并“多认赛博义父”。
智谱和MiniMax,进入“低价增长”时代
智谱、MiniMax等国内头部大模型厂商集体陷入低价增长竞赛,行业从技术溢价竞赛转向用户规模与生态争夺。