B模型成功率94.5%!Token级奖励打开长链路智能体训练新思路

多轮语言智能体任务通常仅设置终点奖励,但一条包含搜索、工具调用、多轮决策的完整执行轨迹里,决定任务成败的往往是不起眼的查询词、动作选择或对象判断,这正是多轮智能体强化学习领域长期存在的时间信用分配难题:终点奖励仅能告知模型整条轨迹最终是否合规,却无法指明中间哪一步值得被强化。
多轮智能体训练困在“时间信用分配”瓶颈
当前主流解决方案是让模型先学习任务相关的程序性技能,再回头为无技能轨迹中的token打分,但教师打分的高置信度并不等同于该步决策真的对任务有帮助,模型可能只是更偏好某种句式、格式或语言表达,无法将信用精准关联到实际影响任务结果的动作上,传统方案始终没有解决“教师偏好”和“实际任务回报”脱节的核心问题。
中科大阿里联合提出ADRS三层修复机制
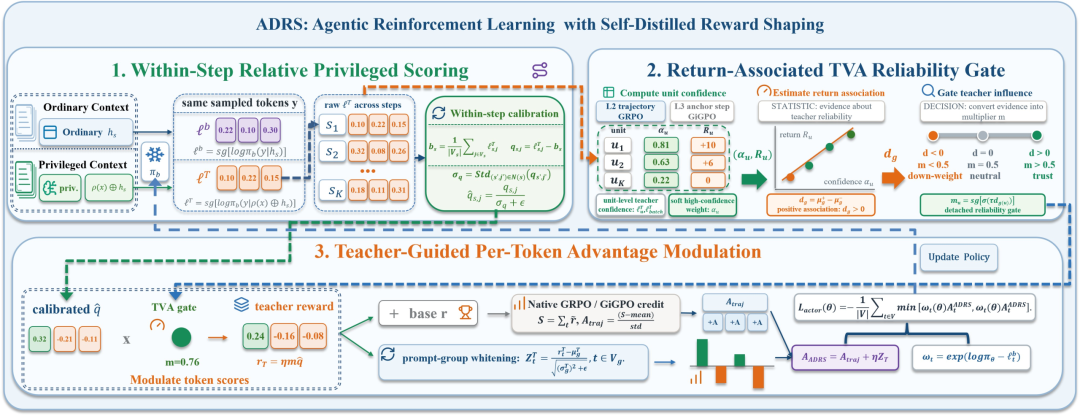
针对上述问题,来自中国科学技术大学与阿里巴巴集团的研究团队提出ADRS(Agentic Reinforcement Learning with Self-Distilled Reward Shaping)框架,核心是将训练期的特权技能转化为与最终回报直接相关的token级信用,直接接入原生reward-to-advantage-to-policy更新路径,从三个层面修复教师信号失真问题:第一层是步骤内教师分数中心化与尺度归一化,保留“当前步骤内哪些token相对更受教师支持”的相对证据,摒弃跨步骤原始分数的绝对参考价值;第二层是TVA(Teacher Value Advantage)门控机制,根据同一比较组内“教师置信度—实际回报”的关联强度调节信号权重:只有当教师更偏好的token确实出现在更高回报的轨迹中时,指导信号才会被放行,关联较弱时教师信号不会默认成为任务信用;第三层摒弃独立的蒸馏反向传播支路,将门控后的token信号在advantage构造之前注入,与环境奖励共同进入策略更新流程。三个模块分别回应“教师偏好什么”“何时与回报相关”“如何进入策略更新”三个核心问题,从根源上解决了传统方案中教师信号与任务实际回报脱节的问题。
3B模型长链路任务成功率可达94.5%
实验数据显示,消融测试中基线模型GiGPO成功率为82.8%,移除TVA模块的ADRS模型成功率提升至87.5%,完整ADRS-TVA模型成功率进一步提升至89.8%,TVA模块在token级特权信用之外额外带来2.3个百分点的提升,验证了“教师偏好”与“教师偏好是否和回报相关”是两个独立的问题。token级诊断显示,训练至150步时,action与style token的更新幅度比达到95.3,说明ADRS并非平均强化整段回答,而是将更新精准对准真正决定执行结果的动作和对象。
数据效率上,ADRS仅使用60%的训练数据即可超过全量GRPO的表现,在未见过的任务上平均高出11.9个百分点。当最大交互步数增至50的长链路场景时,3B参数的ADRS模型成功率可达94.5%,远高于对比方案的84.4%,交互链路越长优势越明显,小模型也能在复杂长链路任务中取得接近SOTA的表现。相关研究已被论文《Agentic Reinforcement Learning with Self-Distilled Reward Shaping》收录,作者包括Ranxu Zhang、Guinan Chen等来自中国科学技术大学与阿里巴巴集团的研究人员。
Token级奖励机制为智能体训练开辟新路径
长期以来,长链路智能体训练的核心瓶颈在于终点奖励的模糊性,中间步骤的决策误差无法被精准识别和强化,导致模型在复杂多轮任务中表现不佳。ADRS框架通过将特权技能转化为与回报绑定的token级信用,无需依赖完整的中间步骤标注,既降低了训练成本,又提升了信用分配的精准度,尤其在长链路、多决策的复杂智能体任务中优势显著,为后续多轮对话智能