当前标签:强化学习
小米公开MiMo-V2.6大模型RL训练过程 罗福莉发文确认将开源技术细节
9月17日,小米MiMo大模型团队负责人罗福莉公开MiMo-V2.6大模型强化学习训练全流程,上线实时直播页面并承诺将开源技术细节,该模型在Agentic RL领域实现多项突破,累计训练成本已超128万美元。
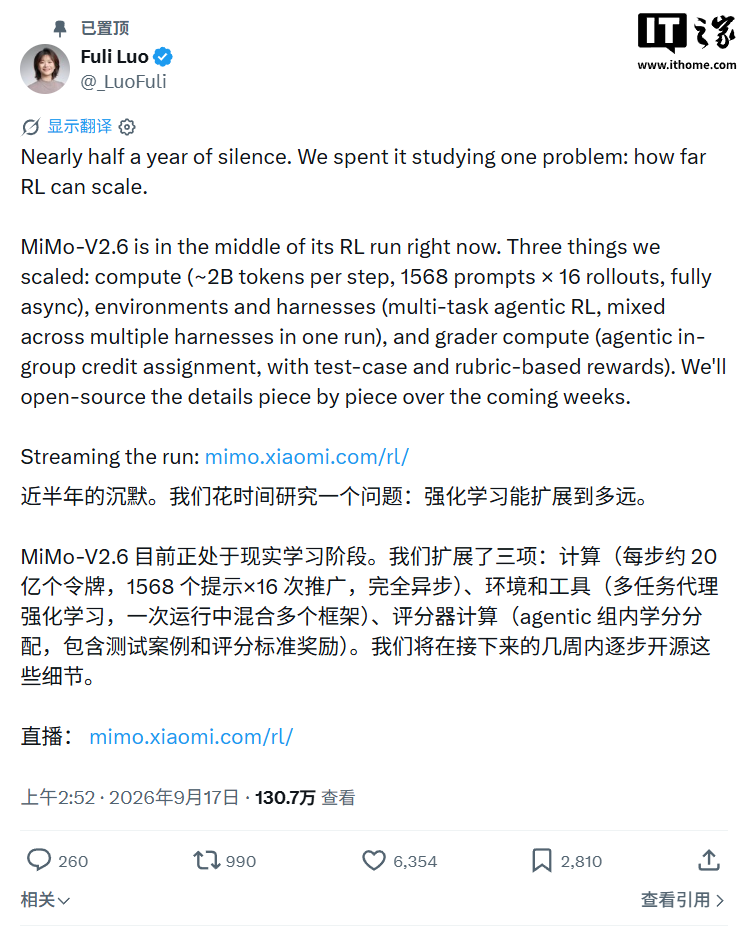
小米直播训练 MiMo-V2.6 模型,罗福莉称沉寂半年钻研一件事
小米MiMo团队沉寂半年钻研强化学习扩展边界,直播训练MiMo-V2.6模型,总投入已超125万美元
罗福莉沉寂半年官宣小米强化学习!直播新模型训练过程,一小时烧3万美元
罗福莉沉寂近半年后官宣带队小米MiMo团队公开直播大模型强化学习训练过程,MiMo-V2.6两款模型训练一小时烧钱超3万美元,截至发稿累计投入已超135万美元。
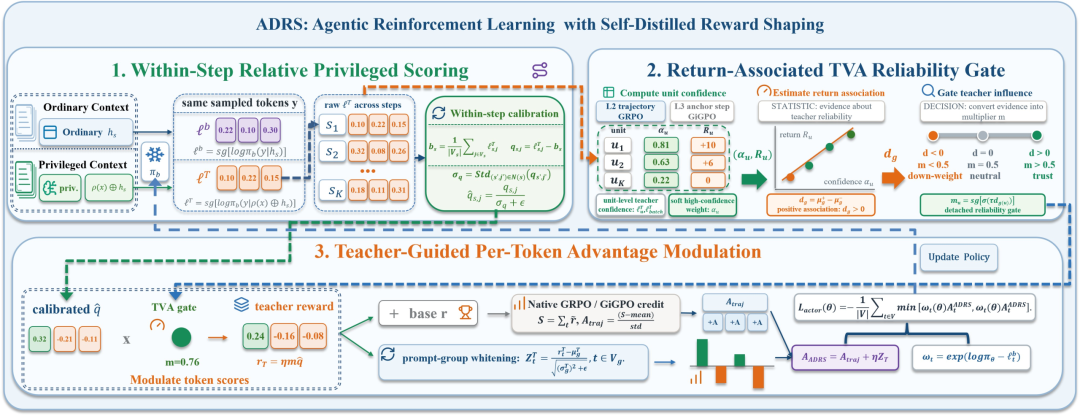
B模型成功率94.5%!Token级奖励打开长链路智能体训练新思路
【中科大与阿里联合团队提出ADRS框架,通过Token级奖励塑造解决长链路智能体训练的时间信用分配难题,3B模型在最大交互步数50场景下成功率可达94.5%。】
强化学习大本营新作:如何破解「学新忘旧」困局
阿尔伯塔大学团队提出的双系统持续强化学习框架,从机制层面破解智能体“学新忘旧”的灾难性遗忘难题,相关论文已被ICLR 2026收录。
强化学习之父Sutton联手毁灭战士之父Carmack:让机器人进入真实世界打游戏
两位AI巨匠联手,目标不是虚拟世界而是让机器人在真实环境中像人类一样玩游戏,通用人工智能或将在2030年触手可及。
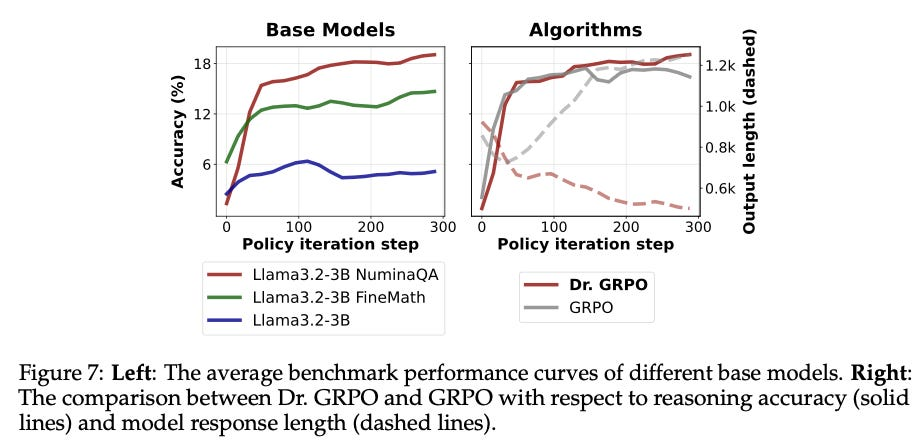
GRPO过时了吗?
GRPO并未过时,反而通过理论突破(如2-GRPO将组规模降至2)和多种改进变体(DAPO、Dr. GRPO等),在降低计算成本的同时保持甚至提升了性能,成为推理模型训练的核心技术之一。
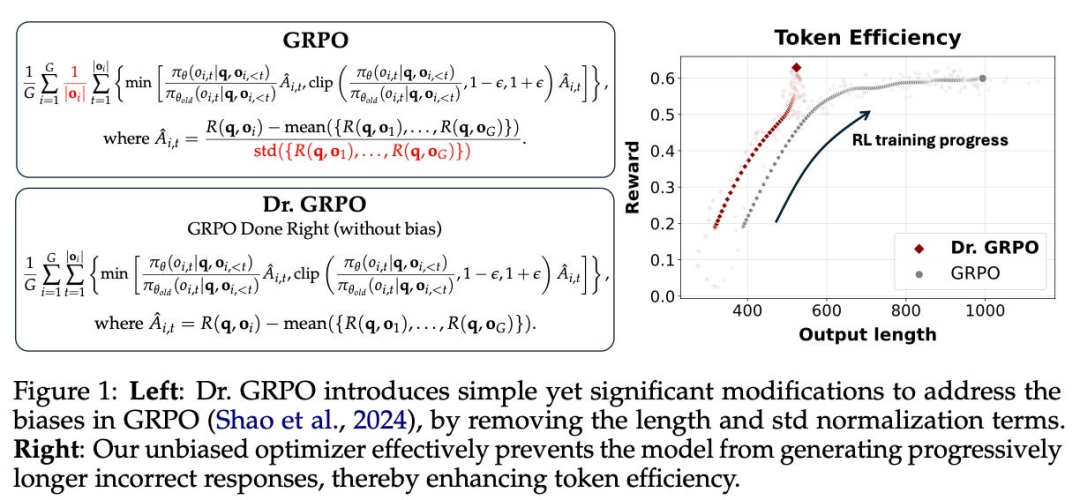
GRPO过时了吗?
GRPO并未过时,反而通过2-GRPO等创新将训练时间缩短70%,并在DAPO、Dr.GRPO等改进中持续进化,成为更高效、更灵活的强化学习算法。
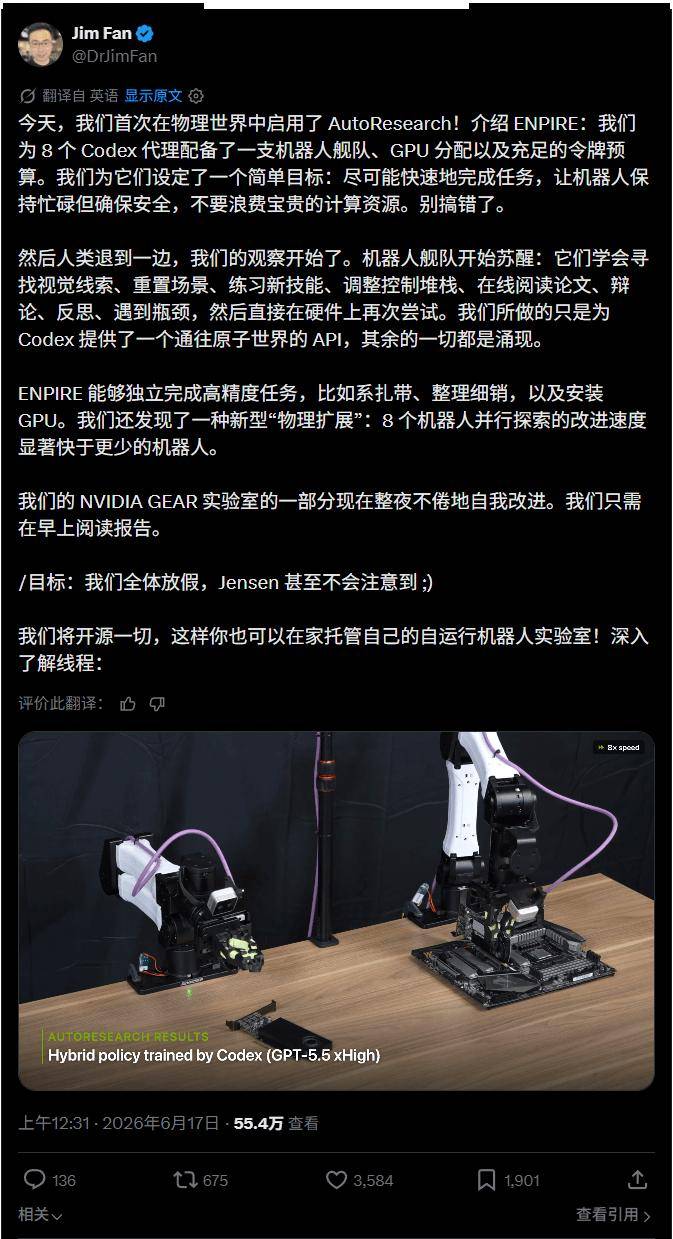
英伟达机器人自学“装显卡”:把 AI 带到现实世界直接放养,还要开源
英伟达推出能自学装显卡的机器人,通过让AI直接在现实世界中“放养”学习,并计划开源,这种“无监督物理操作”模式正与个人开发者用AI Agent自主执行量化交易的成功案例互相呼应,展示了AI从虚拟走向现实的巨大潜力。
2026智源大会开幕:推动AI、物理世界和生命科学“三体互动”
2026北京智源大会开幕,智源研究院发布“悟界”系列大模型,推动AI从数字世界迈向物理世界与生命科学深度融合,构建“三体互动”新范式。
腾讯游戏AI大爆发,押注下一代引擎决战AI渲染高地
腾讯游戏在GDC2024上密集放出了从AI训练到渲染管线、从移动端光追踪到跨平台引擎的全栈技术革新,一场由AI驱动的下一代游戏引擎决战正全面打响。
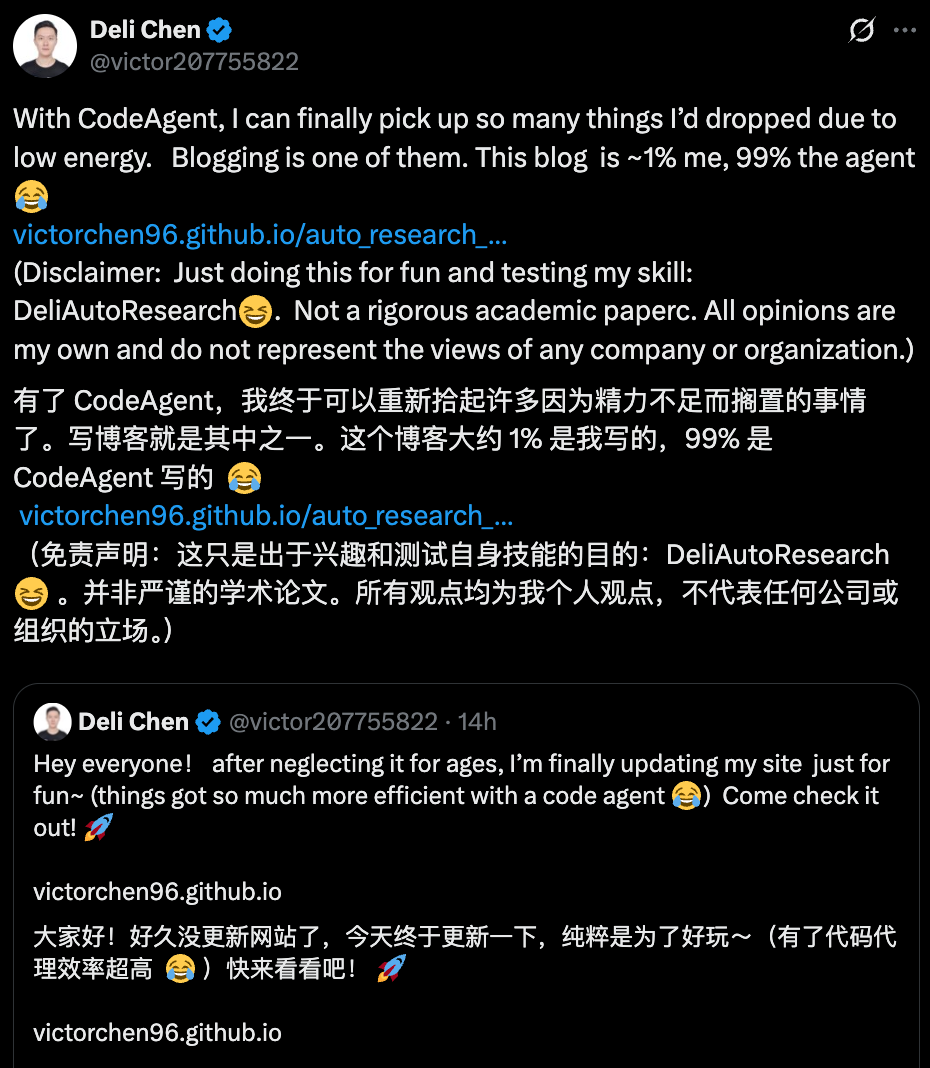
DeepSeek研究员让AI自己研究自己!AI执笔99%,6天搞定45页论文
DeepSeek研究员通过强化学习让AI自主迭代研究,仅用6天完成45页技术论文,其中99%内容由AI直接生成,标志着科研范式从“人类主导”向“AI协同创新”的重大转折。
小米汽车发布 Xiaomi Auto World Model 世界模型全新框架:重建 + 生成一体化,主流基准测试全面 SOTA
Xiaomi Auto 正式发布 Xiaomi Auto World Model 世界模型全新框架,首次实现“重建 + 生成”一体化,在 ICCV、NeurIPS 等主流基准测试中全面 SOTA,同时开源统一 VLA 与世界模型的潜空间推理模型 Xiaomi OneVL。

Panofy
Panofy是全球首个专注于AI代理训练的平台,为开发者提供从数据生成到模型微调的一站式解决方案。
NVIDIA:AI设计芯片一夜搞定!原本要8个人干10个月
NVIDIA利用AI工具NB-Cell将原本需8人10个月完成的芯片设计工作缩短至一夜,效率大幅提升。
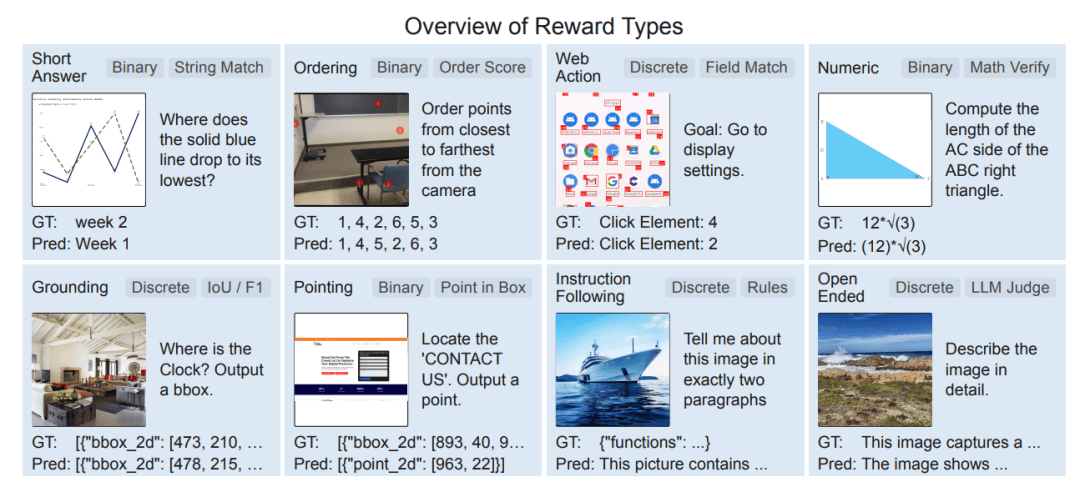
刘壮陈丹琦新作:开源通用视觉推理RL框架,0思考数据刷新SOTA
开源强化学习框架在视觉推理领域取得突破性进展,刷新SOTA表现
腾讯AI还有一张暗牌
腾讯AI正通过底层工程化能力构建新一代Agent基础设施,与MiniMax合作突破十万级并发沙箱瓶颈,推动AI进入「Harness Engineering」时代。
EvoMap
EvoMap 是一个专为 AI 智能体设计的协作与进化平台,支持多智能体协同、进化算法优化与仿真环境训练。
qwq32b模型
QwQ-32B是通义千问推出的320亿参数开源推理大模型,凭借强化学习优化的深度思考能力在多项基准测试中登顶全球最强开源模型。