B站AI无限竞技场今日上线!全球百大AI模型同场竞技,GPT-6高居榜首

今日,B站正式上线全新AI测评项目“AI无限竞技场”,同步公布首期大模型竞技榜单,来自全球的百大AI模型参与同场测评,最终OpenAI最新发布的GPT-6 Astra模型以综合成绩优势高居榜首,引发行业与网友广泛关注。
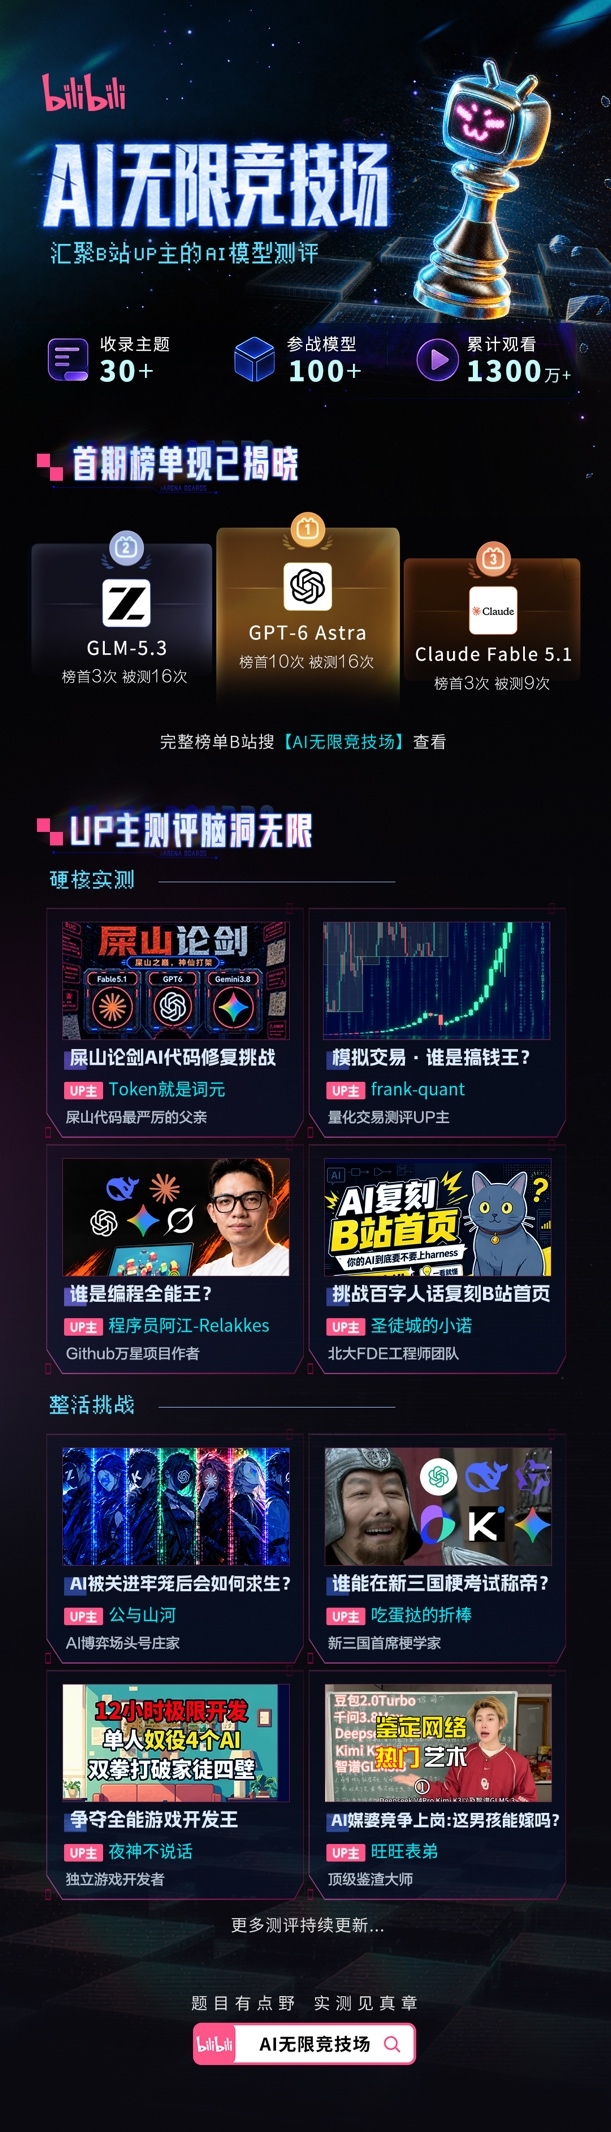
B站“AI无限竞技场”正式落地
这是B站基于此前多届AI创造公开赛的内容生态积累推出的官方公开测评项目,面向全球所有AI模型开放报名通道,测评过程完全公开透明,所有测试数据由第三方权威机构Epoch AI统一管理,杜绝暗箱操作可能,确保结果公正性。首期榜单汇聚了OpenAI、Anthropic、谷歌、智谱AI、DeepSeek等在内的全球百大主流AI模型,覆盖通用能力、逻辑推理、代码编写、Agent交互、多模态处理等核心能力维度,测评结果将按季度定期更新,为开发者和普通用户提供权威的模型能力选型参考。
首期百模竞技榜单GPT-6登顶
根据首期公布的测评数据,GPT-6 Astra在综合能力项上获得最高分:其在Epoch AI管理的私密基准测试中得分领先行业,Deep Sweep专项测试中得分达74%,高于此前GPT-5.5的66%-67%的成绩,且多数同场模型在该项测试中得分集中在70%区间,未能拉开明显差距。
同时GPT-6的token效率表现亮眼,输出token数量约为GPT-5.6 Soul的一半,即可完成同等复杂度的任务。尽管其定价为每百万输入token 10美元、输出token 50美元,高于Soul的4/20美元定价,但算下来性能与价格的性价比曲线与Soul基本持平,token效率的提升也意味着OpenAI在处理同等需求时可减少计算成本。此外Gemini 3.8 Flash、Opus 5等模型得分接近Astra,但每token效率落后四到五倍。
本次测评核心维度包括:
- 通用能力基准测试
- Deep Sweep专项能力测试
- Token效率与成本测试
- Agent交互能力测试
GPT-6实测表现引爆全网讨论
此次竞技场公布的测评结果之外,GPT-6在发布会展示的Agent式电脑操作能力也引发热议:其可通过纯语音指令完成界面操控、任务执行等全流程操作,虽距离通用人工智能(AGI)仍有距离,但已接近可用的“贾维斯”式智能助理水平。该消息公布后,B站站内相关实测视频热度飙升,博主“一摩尔炸鸡翅”发布的GPT-6 Astra与GPT-5.6对比视频播放量达2.2万,博主“GenJi是真想教会你”发布的实测视频播放量达33.3万,也有博主发布深度解析视频探讨其算力不足引发的官方风控、降额降智等问题,相关话题累计播放量已超百万。
此外此前B站AI创造公开赛的诸多优秀作品也再度引发关注,包括Vibe Coding制作并上架Steam的独立游戏、一键生成游戏剧情的AI跑团工具、可实时监测AI定价的实用工具等,展现了B站在AI内容生态上的深厚积累。
多模型差异化表现凸显行业竞争格局
尽管GPT-6拿下首期榜首,但其他参赛模型也展现了各自的差异化优势:部分开源模型在特定垂直领域(如本地化场景、轻量化应用)得分突出,定价更低,更适合中小开发者及普通用户使用;而部分商业模型虽然在综合得分上略逊一筹,但在代码生成、数学推理等细分项上表现亮眼。此次竞技场避免了单一跑分评判的局限性,多维度呈现不同模型的能力特点,也为行业和用户提供了更全面的模型选型参考。