华为昇腾960超节点落地 AI算力竞争从单芯片转向系统工程

9月17日,华为全联接大会2026在上海开幕,华为副董事长、轮值董事长汪涛发表主题演讲“智启新未来,打造智能世界的硅基黑土地”,正式发布新一代AI算力基础设施昇腾960超节点。华为称该产品为业界首个采用NPO(近封装光学)技术的超节点,单节点最多可搭载4096张算力卡,最大提供8E(EFLOPS,约800亿亿次/秒)FP8算力与1PB HBM容量,可匹配10万亿参数级大模型的训练与推理需求。
昇腾960超节点正式发布 算力规格较上代翻倍提前落地
汪涛在演讲中列举了一组AI需求爆发数据:大模型参数正快速迈向10万亿,2030年将达100万亿以上;中国每日推理Token已增长到500万亿左右,2030年将达百万万亿级;端侧模型从2024年的3B发展到当前的30B,未来将走向100B级。他指出,算力需求的增长速度远超芯片单点性能的提升速度,华为的解决方案是将竞争单位从单颗芯片扩大到整个系统,通过“超节点+集群”架构释放整体算力。
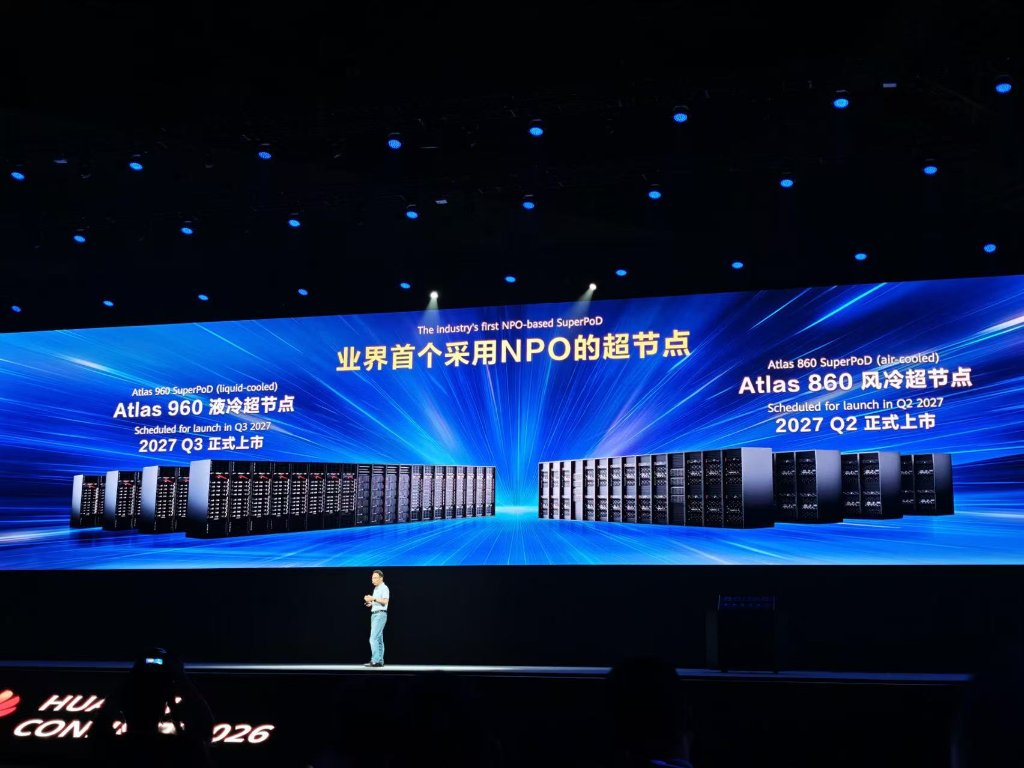
昇腾960芯片的研发进度超出预期:其中面向训练场景的960DT版本较原计划提前三个季度,将于2027年第一季度就绪;面向推理场景的960PR版本提前一个季度,将于2027年第三季度就绪。该芯片支持华为自研的HiF4数据格式,推理吞吐较业界FP4方案提升明显,且精度表现更优。根据华为公开的路线图,2028年、2029年将陆续推出昇腾970、980产品,依托τ定律实现算力规格的持续翻倍。
目前华为已有算力产品实现规模商用:昇腾910C超节点累计部署超1000套,昇腾950超节点也已正式投入商用。
Hi-ONE光互联模块量产应用 破解万卡集群通信功耗痛点
万卡级算力集群的核心瓶颈在于卡间互联效率。传统大规模算力系统主要依赖铜缆进行电互联,当单芯片带宽迈向Tbit级时,铜缆的有效传输距离被压缩到厘米级,且跨服务器互联带宽多为200-400Gb/s,时延达数十微秒,千亿参数模型训练场景中频繁的GB级数据通信阻塞会导致大量计算资源等待通信,同时万卡级集群的故障概率呈指数级上升,系统运维成本快速攀升。
华为通过NPO