当前标签:大模型训练
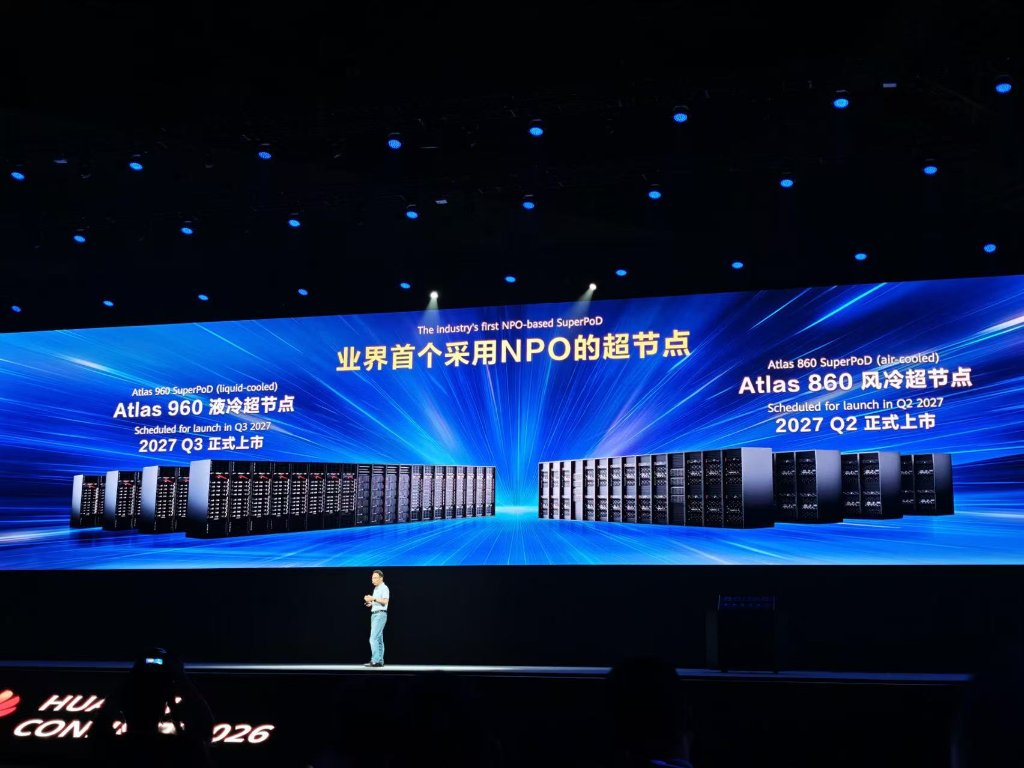
华为昇腾960超节点落地 AI算力竞争从单芯片转向系统工程
华为发布业界首个采用NPO技术的昇腾960超节点,单节点最高可提供8EFLOPS FP8算力,标志着国产AI算力竞争正式从单芯片性能比拼转向系统级系统工程能力角逐。
每小时烧掉三万美元!前DeepSeek大牛罗福莉加盟小米后首度直播大模型训练
小米MiMo大模型负责人罗福莉直播最新大模型MiMo-V2.6强化学习训练,双版本训练合计每小时花费超3.1万美元,折合人民币超20万元,引发行业热议。
中文互联网基础语料 4.0 发布:数据量 120GB,为大模型训练和 AI 发展提供可信数据支撑
中文互联网基础语料4.0在2026年国家网络安全宣传周人工智能安全治理分论坛正式发布,总数据量达120GB,将通过官方语料平台向社会开放获取,为国产大模型训练与AI产业高质量发展提供可信数据支撑。
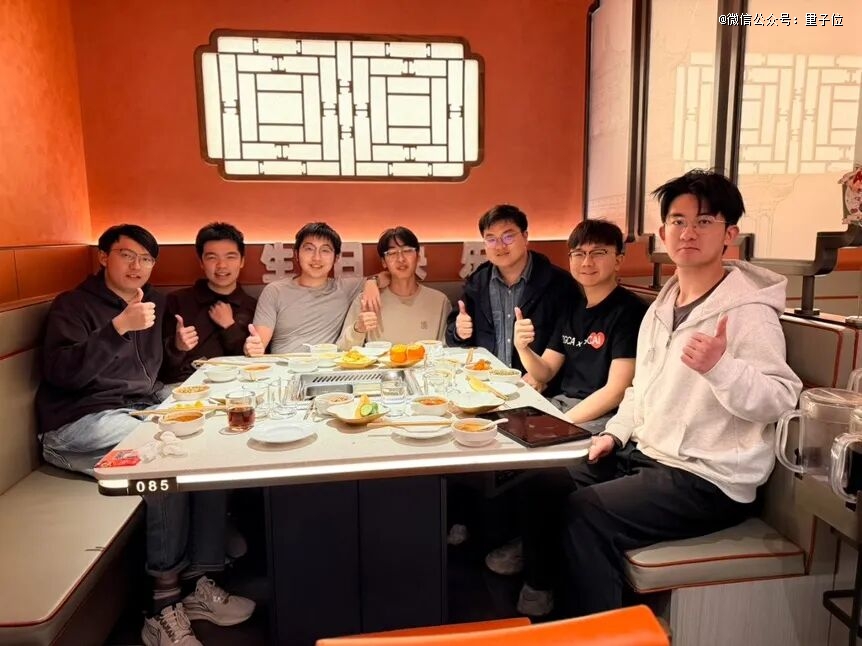
七名博士生仅用三个月从零训练7B大模型:代码+数据+训练日志全公开
七名跨学科博士生仅用三个月从零训练出7B开源大模型,全流程代码、数据、训练日志完全公开。
月耗万亿Token:金山办公为什么不自己训练大模型
月耗万亿Token的天文数字背后,是算力、数据和专业壁垒的三重考量,金山办公选择调用成熟模型而非自研,是商业与技术最优解。
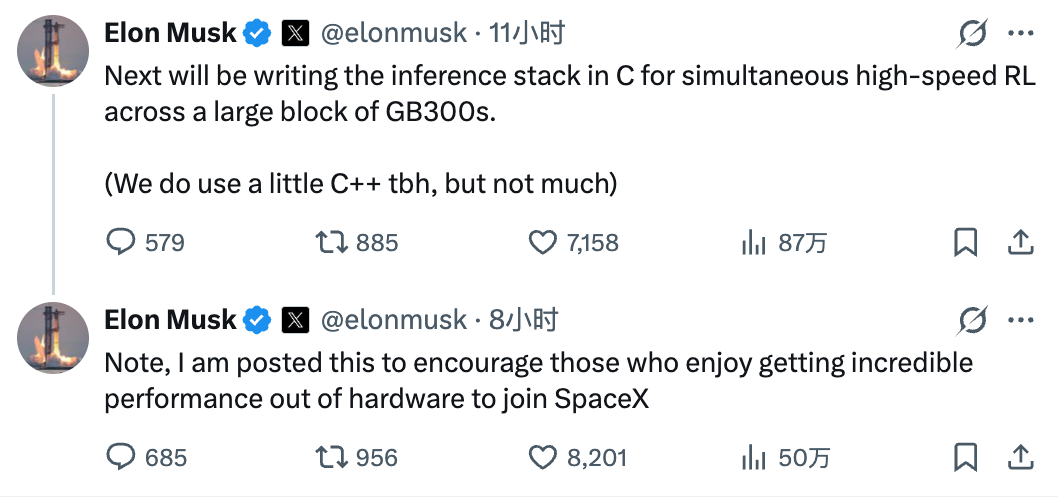
马斯克也拥抱C语言了,大模型训练堆栈抛弃JAX,提速一个数量级
埃隆·马斯克旗下xAI团队宣布放弃深度学习框架JAX,全面转向C语言重构大模型训练堆栈,实现整体性能提升一个数量级,震惊业界。
LabelLLM
LabelLLM是一款专注于大模型对话数据标注的开源免费平台,帮助用户高效处理和标注对话数据。
DeepSpeed
DeepSpeed是由微软开发的开源深度学习优化库,专为大规模模型分布式训练打造,能显著提升训练效率与规模。
Cephalon端脑
聚焦AI算力的分布式应用部署平台,提供极高性价比的一键部署方案。