阶跃发布StepAudio3系列模型:五款模型同步上线开放平台

9月15日,阶跃星辰正式发布新一代语音大模型StepAudio 3系列,一次性推出五款细分模型,覆盖实时语音交互、语音识别、真人级语音生成、音频内容生成及音乐创作五大核心场景。目前,五款模型均已上线阶跃星辰开放平台,开发者可直接调用相关API接口。这是阶跃星辰继此前推出Step-Audio 2 mini、StepAudio 2.5系列语音产品后,在语音大模型领域的又一次重磅迭代。过去一年,阶跃星辰开放平台API调用量增长近20倍,活跃用户数量增长5倍,生态基础已具备规模化落地的条件。
阶跃星辰9月15日推出五款StepAudio 3系列语音大模型
本次发布的五款模型分别瞄准不同应用场景:其中实时交互、语音识别、语音生成类模型面向通用交互需求,音频内容生成、音乐创作类模型则面向专业内容生产场景,形成了从基础交互到内容生产的完整语音大模型矩阵,也标志着阶跃星辰正式补齐了AI技术栈中语音板块的最后一块拼图。
StepAudio 3系列多款核心模型性能登顶全球榜单
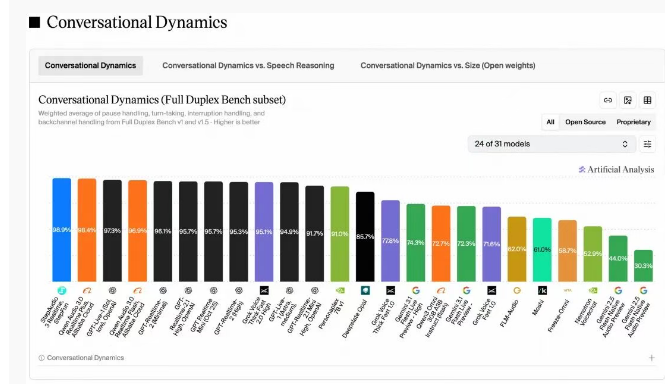
五款模型均具备行业领先的性能指标,多款在权威评测中位列全球第一:
- StepAudio 3 Realtime:原生全双工实时对话模型,可同时理解语义、语气、情绪及环境音,在Artificial Analysis榜单中综合得分98.9%,位列全球第一;
- StepAudio 3 ASR:融合大模型上下文理解的语音识别模型,支持方言、中英混说及医疗、法律等专业场景,词错率(WER)低至1.7%,并列全球第一;
- StepAudio 3 TTS:真人级语音生成模型,强化副语言表现,支持流式生成,可还原笑声、迟疑、停顿、结巴等真实交流中的非语言细节,生成与播放同步进行,完美适配实时语音应用需求;
- StepAudio 3 Gen:全链路音频内容生成模型,可基于自然语言描述和参考音频,统一生成人声、音效、环境音和背景音乐,支持对多角色音色、情绪、方言口音及副语言特征进行精细控制,还可编排不同声音元素的出现时序,将传统多环节的音频制作流程压缩到一次生成中;
- StepAudio 3 Music:专业音乐创作模型,支持歌曲创作、清唱配乐、歌曲翻唱等多种功能,基于ABC记谱法可实现多轮交互创作,用户可提供歌词、清唱、参考曲目等输入,让模型围绕已有创作片段完成编曲、改编等全流程制作。
全栈语音能力补全阶跃星辰AI技术闭环
此前阶跃星辰已完成基础大模型、端侧模型、智能体系统、终端硬件的全链路布局:2026年7月,其发布全球首个智能体原生操作系统Step AOS、个人智能体阶跃Amoo、端侧模型家族Step Edge,与千里科技合作推动AI能力落地汽车领域,与艾为电子合作推出全球首款大模型原生智能体手机STEPX Neo,已打通从模型、系统到终端的完整技术链路。StepAudio 3系列的推出,补齐了其语音交互与音频生成的核心能力,形成了文本、多模态、语音的全栈大模型体系,可进一步支撑智能体、智能汽车、AI手机等终端场景的语音需求,为全场景智能落地提供更完整的底层能力支持。
技术落地仍待场景验证与生态规则完善
尽管StepAudio 3系列多项性能指标位列全球第一,但从实验室性能到商用落地仍存在诸多挑战:全双工实时交互对网络延迟极为敏感,弱网环境下的体验稳定性仍需优化;多角色、多音效的精细控制对普通用户存在一定使用门槛;AI生成音频、音乐内容的版权归属规则尚未明确,相关合规问题仍需行业共同探索。此外,榜单性能优势也需要在客服、教育、娱乐等高频场景中完成大规模商用验证,才能真正转化为商业壁垒。随着阶跃星辰开放平台生态的持续完善,StepAudio 3系列有望在更多垂直场景中落地,进一步推动AI语音技术的普惠