七名博士生仅用三个月从零训练7B大模型:代码+数据+训练日志全公开

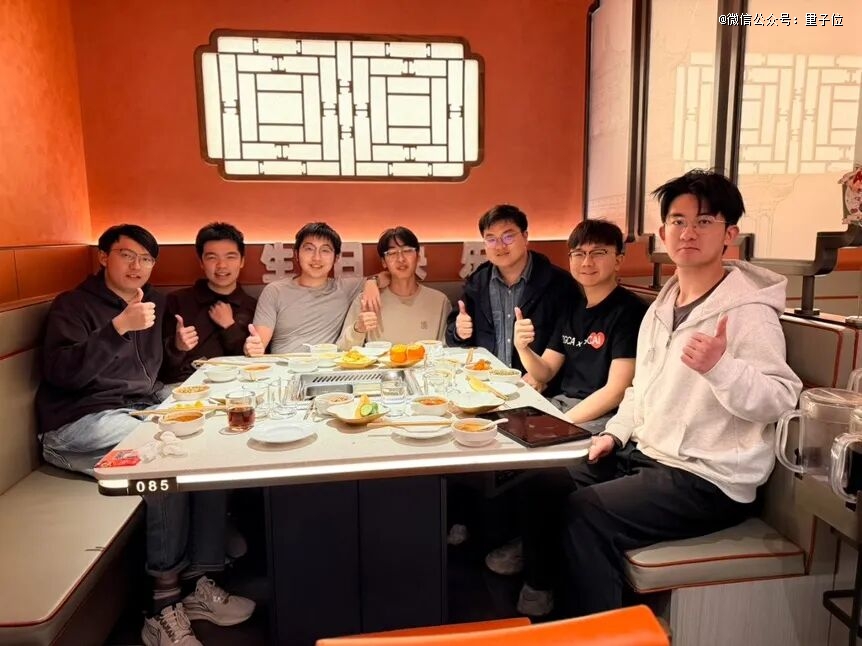
一顿火锅聊出的7B模型训练设想
七名分别来自人工智能、网络、化学、生物、网络安全方向的博士生,此前大多在现有开源模型基础上做微调,看了大量技术报告却始终有诸多困惑:数据筛选的实际决策逻辑、训练故障的排查方法、报告中轻描淡写的“数据清洗”背后对应多少工程工作量,这些问题始终没有清晰答案。最初那顿火锅上聊出的想法,终于落地成了完整的工程实践:大家萌生了从零开始完整训练7B大模型的目标,甚至想尝试让模型通过思考、搜索、使用工具来弥补参数量带来的知识储备不足,挑战现有主流模型性能。团队将设想提交给指导老师后,获得初始算力支持,先快速复现已有项目跑通小模型全流程,用实际进展拿到了更多算力资源,饭桌上的设想正式落地为每日推进的工程项目。
训练遇卡壳数百Agent组成“外援团”
真正启动7B模型训练后,团队发现大量论文里的概念在实际改代码、解释实验现象时根本派不上用场,频繁在工程环节卡壳。为此团队让Agent从底层原理开始调研讲解,讲完后立刻回到代码和实验场景中验证,原本抽象的理论知识开始对应具体的工程实现,也帮团队搞清楚了训练跑不起来的具体原因。模型训练完成后,团队还对整个研发流程中Agent的实际表现做了评级,希望基于这次完整的预训练实践,为当前大模型研发领域的RSI(研发智能化)现状提供可参考的工程结论。
全链路公开打破预训练“黑箱”
本次发布的ZGCM-1模型,团队完全公开了训练全流程的所有核心资源,没有任何保留环节,相关资源已统一上传至公开仓库:
- 完整的训练、数据处理代码
- 模型权重文件
- 全流程训练日志
- 训练用数据集
针对当前大模型领域“开源权重易得、预训练决策逻辑却完全闭源”的普遍问题,团队表示最初就是想把自己的完整实践过程留下来,给其他高校里有类似好奇心的研究者提供可复现、可参考的范本,让更多人能搞懂“大模型到底是怎么训出来的”,而不是只会调用现成模型做微调。
北京中关村学院跨学科团队联合攻关
本项目由北京中关村学院与中关村人工智能研究院的何纪言老师指导,由AI核心学部、软件智能研究所、未来实验室的师生共同完成,核心成员按姓氏拼音排序为冯文俊、关浩祥、郭俊毅、梁广、柳浩、沈逸飞、孙锦博、谢彦泰,另有陈凯、李亚韬、刘铁岩等十余位师生参与项目支持。
(发稿时间:2026年9月15日)
本文系量子位获授权刊载,观点仅为原作者所有。