全球AI视频榜单第一梯队再添中国力量:智象发布首款物理规律导向视频模型

9月15日,智象未来(HiDream.ai)正式发布首个原生全模态视频生成模型HiDream-O1-Video-1.0(简称HD-V1)。该模型采用智象自研原生全模态架构,支持文本、图片、视频等多模态输入,可一键直出5-20秒1080p高保真视频,在意图理解、物理规律理解、自主规划叙事、音画一体化生成等维度均达到全球领先水平。
智象未来CTO姚霆表示,视频生成的代际进化从来不是像素提升和时长延续这么简单,核心在于模型是否真正理解创作者的意图和真实世界的物理规律。HD-V1从架构设计之初就面向文本、视频与音频的统一表征,原生全模态技术让模型从“看得清、动得顺”,升级到“听得懂、说得准、演得连贯”,此次在两项国际权威榜单中进入第一梯队,是对智象原生全模态技术路线最直接的验证。
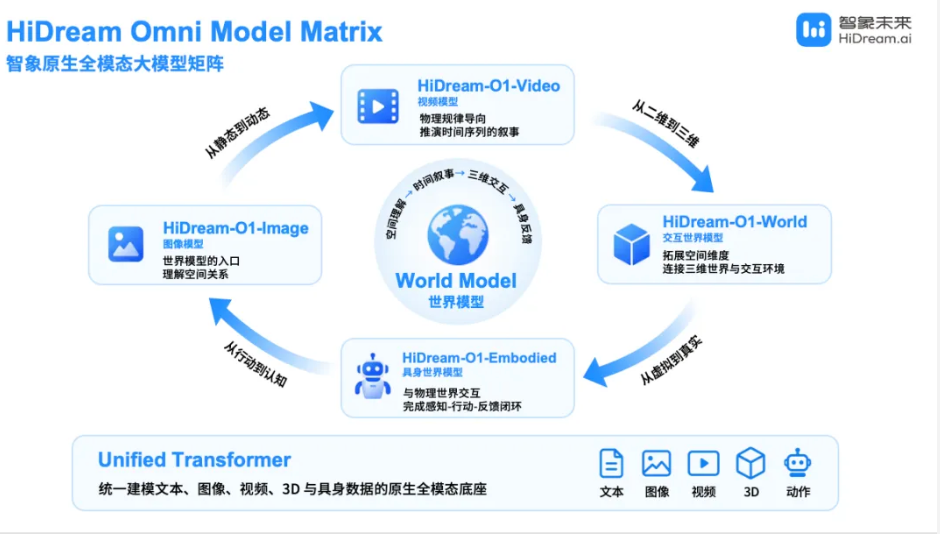
智象正式推出首款物理规律导向视频模型HD-V1
HD-V1是智象原生全模态世界模型矩阵的核心组成部分,首次将物理规律导向作为视频生成的核心设计逻辑。不同于传统视频模型仅聚焦画面像素匹配,HD-V1从底层架构上实现了文本、视觉、音频多模态的统一表征,能够同时处理自然语言指令、参考图片、前置视频片段等不同类型的输入,最终输出画质清晰、动作流畅、音画同步的高质量视频内容。
HD-V1两大国际权威评测跻身全球第一梯队
发布同期,HD-V1在全球领先的独立AI基准测试与分析平台Artificial Analysis Image to Video Leaderboard(With Audio)排行榜上取得全球第四的佳绩,在全球最具影响力的AI模型盲测评测平台Arena.ai Image-to-Video中也位列全球第八。前者以标准化、可复现的基准对全球头部视频生成模型进行系统评测,是衡量AI视频模型综合实力的核心标尺;后者作为专注AI视频生成的盲测平台,被全球主流AI厂商广泛引用,评测结果直接反映模型的真实用户体验。
从全球AI竞争格局来看,这一成绩的意义远超名次本身:多模态是当下全球人工智能的核心战场,图生视频是其中技术密度最高、竞争最激烈的方向之一。HD-V1以双榜高位成绩完成全球首次亮相,标志着中国优秀大模型企业已在AI视频领域全面领先,正式形成全球AI视频模型第一梯队。
原生全模态架构破解视频生成两大核心痛点
针对当前视频生成领域普遍存在的“听不懂指令、不符合物理规律”问题,HD-V1从架构设计层面做了针对性优化:
- 更懂用户意图:面对用户口语化、碎片化、模糊化的输入,HD-V1前置多模态意图理解模块,借助多模态理解模型的深度推理能力,对视频内容进行全字段结构化规划,覆盖镜头时长、场景地点、画面内容、首帧约束、在场角色、动作表情、景别构图、运镜焦段、台词与背景音效等全维度要素,充分消化用户自然语言意图后转化为模型可识别的专业表达,从源头避免意图漏解、镜头跳戏、人物漂移、音画错位等问题。
- 更懂真实物理规律:HD-V1将重力作用、碰撞反馈、惯性延续、光影衰减、空间连续性等物理规律写入视频生成的底层逻辑,确保生成内容符合真实世界的运行逻辑,画面真实质感得到全面提升。根据公开对比demo,在相同提示词下,