谁在用词元?

词元(token)原本是自然语言处理中“处理文本的最小数据单元”,可以是词、子词、字符或按规则切分的字符串片段。文本先经过词元化,再映射为词汇表索引与向量表示,进入模型计算。但到了2026年,这个词已经不只活在技术文档里:它被写进国家数据局的统计口径,被运营商做成套餐,被大学课堂列为自费耗材,也被骗子包装成“囤词元暴富”的诱饵。
国家数据局把词元写进“40万亿”成绩单
最先大规模“使用”词元的,是统计部门。
国家数据局披露,中国日均词元调用量从2024年初的1000亿增长到2025年9月的40万亿。《人民日报》报道,当周中国大模型调用量以4.12万亿词元首次超过美国的2.94万亿。到了2026年3月24日,《人民日报》又报道我国日均词元调用量突破140万亿。
这些数字进入新闻句式后,读起来很像“出口了多少吨钢材”。在以OpenAI、Google、Anthropic为主语的报道里,常用的是benchmark(评判基准线);而“词元消耗量”听起来更像产能和出货。于是出现了两层语言变化:
- 第一层是命名权。谁的语言定义单位,谁就在这个领域拥有话语权。
- 第二层是类别归属。“词元”悄悄把大模型从“科技产品”归入“工业产能”。
AI不再只是“我们也能做”,而变成了“我们有多少产能”。一旦它被纳入制造业叙事,衡量它的语言也会随之改变。真正有意思的不只是翻译,而是当大模型发展到今天,谁有资格用自己的语言来报这个数。
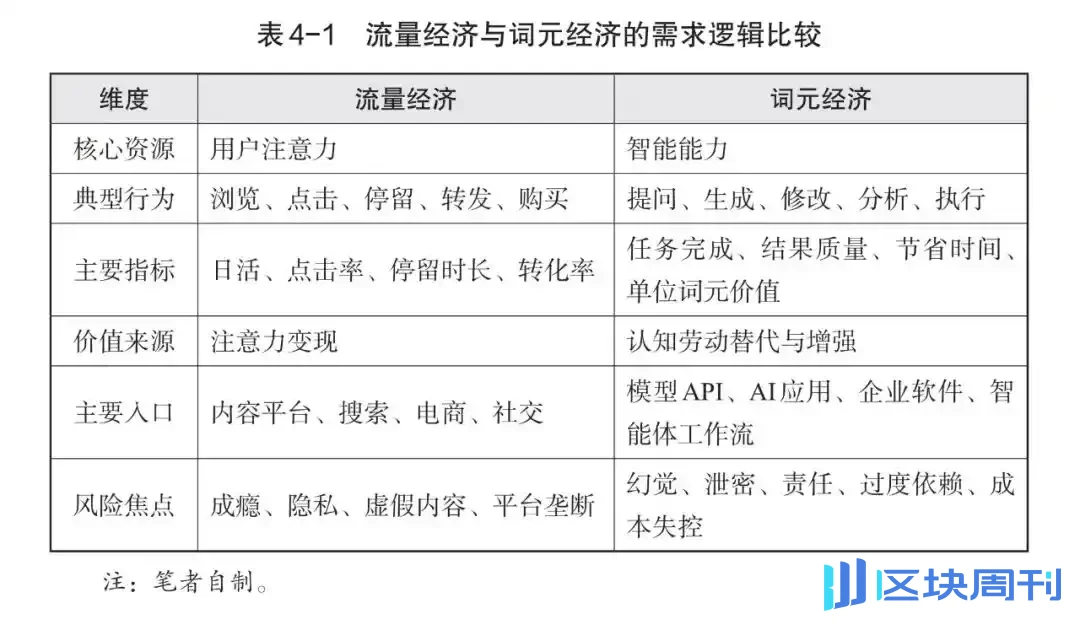
运营商把词元摆上套餐货架
第二类用词元的人,是把它当成商品来卖的人。
运营商推出Token套餐,意味着词元开始和流量、语音一样,成为套餐里的计费条目。对普通用户来说,这个词可能还很陌生;但对企业和开发者来说,按词元调用量付费已经是日常。模型每处理一次请求、每生成一段回答,背后都在消耗词元。
产业重心也在移动:从训练转向推理,从“谁的模型更聪明”转向“谁能处理更多请求,还便宜”。龙虾(AI Agent)爆发后,每一步都要重新喂上下文,极其烧词元,价格迅速变得敏感。与此同时,很多落地业务只是发邮件、整理文件、调用工具。越接近现实场景,模型越不需要聪明,便宜就行。
当词元变成可以大规模供应的资源,它就不再只是技术指标,而开始像一种工业品,一种可以出口的东西。运营商把词元装进套餐,正是这种“工业品化”的一个信号。
南京大学课堂把词元列为自费耗材
第三类用词元的人,是学生和老师。
2026年秋季,南京大学计算机学院副教授、博导蒋炎岩在开学第一课《生成式软件工程》课件的第一页写上:“没有token的CS学生应该立即退学。”“立即退学”甚至还标了红。
这句话听上去像是在用消费能力划一条学业的生死线。但把完整语境放回去,它并不是一条真正意义上的退学标准。蒋炎岩想表达的是另一件事:在如今的计算机教育里,使用大模型已经不是课外兴趣,而开始变成基本的工程能力。一个不碰模型的计算机学生,正在失去的不是某个加分项,而是这门专业当下的工作方式本身。
这门课的规则很具体:token自费,课堂全程使用deepseek-v4-flash,自己花钱买token完成作业。于是,学生成了词元的直接消费者。都2026年了,学计算机的还不碰AI工具,还在用十年前那套方式敲代码,跟行业前沿的差距已经不是熬夜能补上的。
黑产骗子用“囤词元暴富”设局
第四类用词元的人,是骗子。
随着词元爆火,各类“词元骗局”层出不穷。有人用低价AI词元套餐、词元投资等噱头诱骗资金;有人冒充官方平台,以官方升级、验证为由骗取个人隐私信息;尤其是宣称“囤词元能暴富”“场外交易赚差价”的行为,不仅涉嫌非法金融活动,还可能被境外间谍情报机关用以开展数据窃取、资金渗透,危害国家经济安全与数据安全。
围绕词元的安全风险也不只在诈骗话术里:
- 泄露劫持风险。 不法分子可通过跨站脚本攻击(XSS)、公共Wi
