TPAMI'26

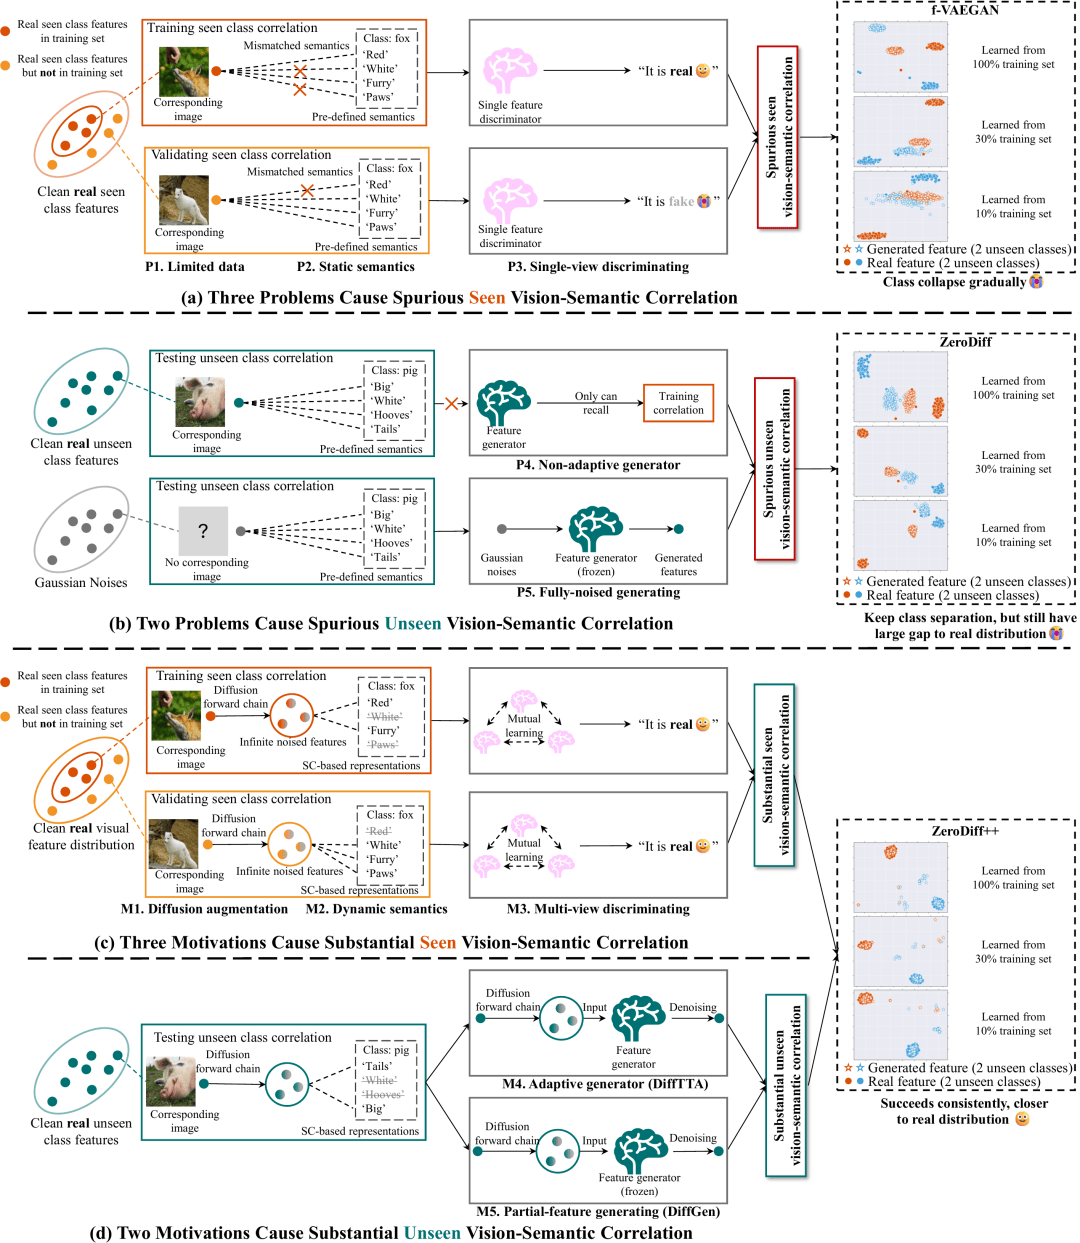
继ICLR 2025推出ZeroDiff框架后,其扩展工作《ZeroDiff++: Generative Test-Time Adaptation for Zero-shot Learning》正式被IEEE TPAMI 2026接收,在零样本学习领域的三项核心公开基准上刷新了state-of-the-art性能。相较于传统GAN-based生成式零样本方法和前作ZeroDiff,ZeroDiff++首次将测试时自适应机制引入生成流程,解决了传统方法生成分布与真实分布脱节的核心痛点,论文Figure1清晰展示了三类方法的思路差异,ZeroDiff++从根源上缩小了合成特征与真实分布的偏差,真正实现了AI模型在应对未知类别测试任务时的动态调整。
传统零样本学习困于“生成分布失真”?
传统生成式零样本学习的通用逻辑为:先在已见类别上学习视觉特征与属性、文本等语义之间的关联,再根据未见类别的语义描述合成虚拟样本,用这些“虚拟数据”训练分类器完成零样本识别。但该方法存在固有缺陷:训练样本有限时,生成器容易记忆训练样本的偶然特征,产生严重过拟合;预定义的静态语义无法表达同类个体的细粒度差异,比如不同毛色、形态的狐狸会被同一组通用属性硬性约束;测试阶段生成器通常处于冻结状态,从纯高斯噪声出发合成的特征,即使类别边界清晰,也容易偏离真实未见类的数据分布。研究团队将这类问题统一归纳为“虚假视觉-语义关联”,并指出数据量越少,训练阶段学习到的关联与真实分布的偏差越大,模型越容易将真实测试样本判定为无效样本。
训练阶段三重加固破解过拟合难题?
ZeroDiff++延续了前作的三项核心训练设计,从数据、语义、判别三个维度共同加固已见类别上的视觉-语义关联,避免生成器记忆有限训练样本的偶然特征:一是扩散增强机制,将同一张干净视觉特征输入扩散前向链,可在不同噪声比例下生成大量训练状态,相当于用单条样本构造连续的数据增强轨迹,降低生成器对原始少量样本的过拟合风险;二是动态实例语义设计,打破预定义属性对所有同类样本的硬约束,引入监督对比表征为每个实例提供动态、细粒度的语义条件,让同类不同个体的差异得到充分表达;三是多视角判别框架,设置三个判别器分别检查生成特征是否匹配类别语义、是否匹配对应扩散过程、是否匹配实例级对比表征,通过基于Wasserstein距离的互学习机制交换不同视角的判别信息,研究团队还从理论层面验证了扩散判别器缓解GAN过拟合的可行性。论文Figure2将有限数据、静态语义、单视角判别、不适应生成器、完全噪声生成这五大问题,与扩散增强、动态实例语义、多视角判别、DiffTTA、DiffGen五项设计一一对应,直观展现了框架的设计逻辑,实验显示当训练数据缩减至常规方案的10%时,该框架仍能保持稳定的生成效果,生成特征与真实分布的偏差远低于此前方法。
测试时自适应闭环实现边“应考”边调整?
ZeroDiff++的核心创新集中于测试阶段,针对传统方法“训练完即冻结”导致的生成分布