小米直播训练 MiMo-V2.6 模型,罗福莉称沉寂半年钻研一件事

9月17日,小米MiMo大模型负责人罗福莉公开了近半年的核心研发进展:自今年4月开源MiMo-v2.5后,小米团队沉寂近半年,集中精力攻关强化学习的扩展边界问题,目前MiMo-V2.6模型的训练过程已开启直播,相关技术细节也将在数周内逐步开源。
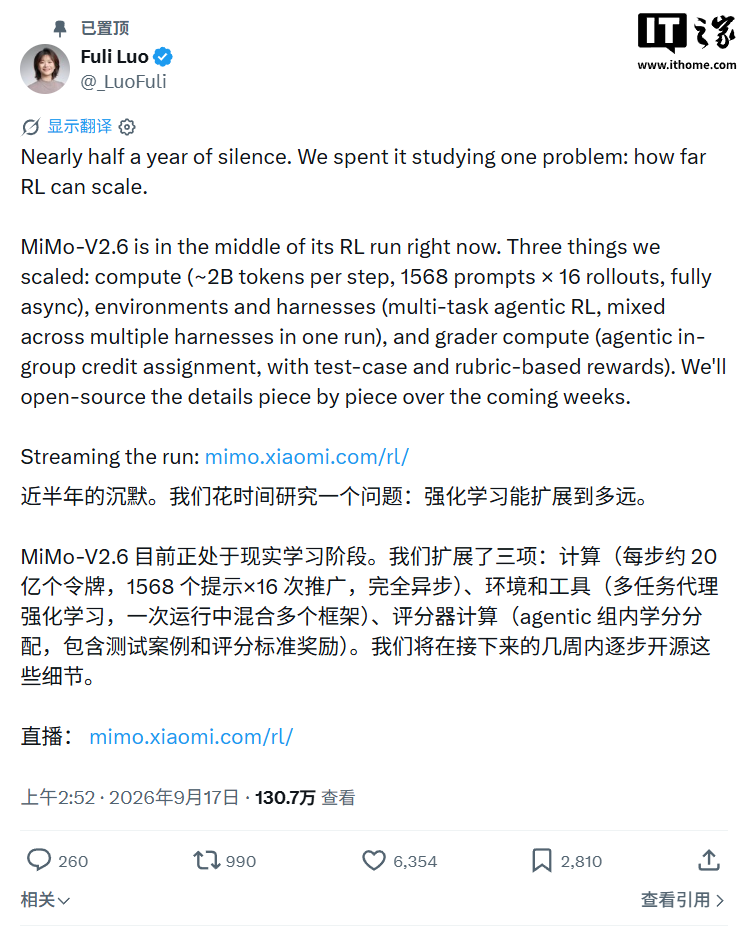
罗福莉官宣半年深耕强化学习Scaling
罗福莉在发文中明确表示,这半年团队只钻研了一件事:强化学习究竟能扩展到多远。当前大模型领域的预训练Scaling路径已经非常清晰:通过叠加更多数据、更大参数规模、更高算力投入,即可获得能力更强的模型,而随着大模型应用向Agent等复杂场景渗透,行业开始关注强化学习是否也能复制类似的Scaling路径——也就是持续提升每轮生成的轨迹数量、模型面对的真实任务环境规模、为判断轨迹质量投入的计算量,模型能力是否还能持续获得提升。小米本次对MiMo-V2.6的优化,正是围绕这三个核心方向展开。
MiMo-V2.6三大维度落地强化学习扩展
本次MiMo-V2.6的训练在三个维度上完成了强化学习能力的扩展,具体配置如下:
- 计算维度扩展:每个训练Step处理约20亿个Token,整体配置为1568个Prompt × 每个Prompt生成16条Rollout,采用完全异步的训练架构,大幅提升训练吞吐量;
- 环境与工具维度扩展:落地多任务智能体强化学习框架,单次运行中可混合多个不同的任务框架,覆盖更丰富的Agent执行场景与工具调用需求;
- 评分计算维度扩展:专门升级Grader Compute能力,给打分/评分过程本身增加算力支撑,落地Agentic In-group Credit Assignment机制,通过测试案例和评分标准生成更精准的奖励信号。
训练直播已上线,总花费突破840万人民币
罗福莉直接公开了MiMo-V2.6模型的训练直播链接,目前总训练花费已超125万美元,按当前汇率计算约合840.3万元人民币,直播页面显示该模型即将正式推出。从公开的训练进度来看,目前两款参数量不同的模型(Flash和Pro)仅训练1天左右,已经展现出明显的能力提升:Pro的dynsam/avg@n指标从训练第1步的约0.565提升至0.614,Flash从约0.514提升至0.603;在最新公开的DeepSWE v1.1离线评测中,Pro和Flash分别取得62.24和60.77的分数,不过对比DeepSeek-Flash v1.1的74.2%仍有提升空间。按照训练速度计算,平均每小时训练花费约3万美元,仅从Pro模型开始训练算起的36小时内,两款模型的总花费已经超过108万美元。
精细化信用分配破解Agent训练信号难题
传统的强化学习训练往往仅以任务最终成败作为奖励信号,对于需要执行数十步复杂操作的Agent来说,这种信号过于粗糙:模型无法知晓多步执行过程中,哪些动作真正推动了任务成功,哪些步骤是无效操作,哪次修改是关键转折。这次MiMo-V2.6训练中落地的Agentic In-group Credit Assignment机制,正是为了解决这一信用分配问题:依托同个Prompt生成16条Rollout的训练配置,通过同组多条Agent轨迹的执行结果对比,输出比简单最终成败更细致的强化学习信号,帮助模型更精准地学习有效操作路径。