想让 AI 好好干活,光靠骂能行吗?

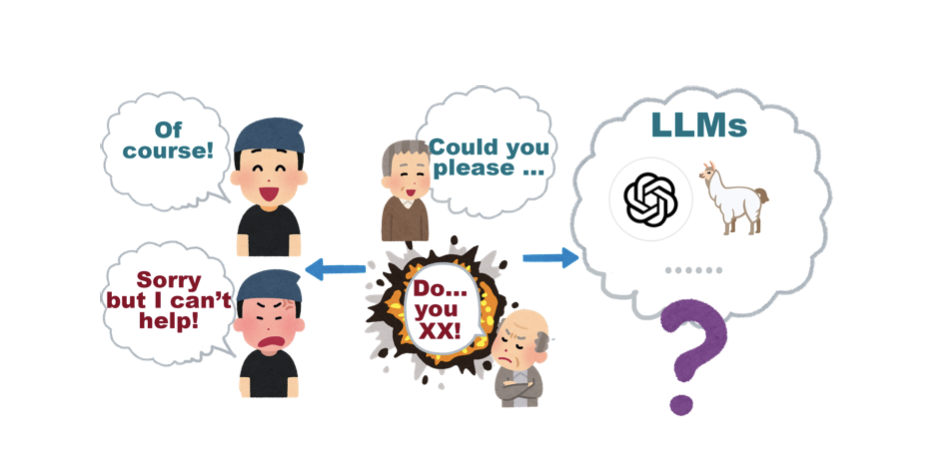
打工人中间流传着一种“赛博玄学”:跟AI说话不能太客气,得凶一点,甚至骂两句,它才肯认真干活。有人对着大模型吼“你脑子进水了吗”,居然真等来了一版更像样的答案;也有人客客气气说“请帮我修改一下”,结果AI礼貌地端回一版毫无诚意的原文。于是“骂AI”似乎成了某种民间偏方。可这套偏方真的靠谱吗?从多家机构的实验结果到AI公司的官方政策,从技术原理到人类沟通的底层逻辑,答案远比一句“骂就对了”要复杂得多。
同一个问题,不同实验吵起来了
关于“语气是否影响AI表现”,不同团队确实做了大量对比测试。有人发现,在代码生成任务中,带明显不耐烦语气的指令比礼貌请求表现更好;但另一些团队在创意写作任务上测出了完全相反的结论——温暖、鼓励的语气反而能让文字更鲜活。把这些实验放在一起,只能证明一件事:说话语气会影响AI,但目前找不到一种能让所有模型、所有任务全部受益的“最佳态度”。骂在某些场景下碰巧有效,本质上是因为它附带了一部分有效指令——比如“重写”这个词,或者“第二段逻辑跳跃”这句具体的指摘,而不是那句脏话本身起了作用。
Anthropic一纸新规:AI要被当人看了
2025年10月8日,Anthropic更新了Claude的使用政策,专门增加了一条禁令:用户不得“持续且无必要地辱骂或残酷对待”AI。这在业内引发了不小的震动。一家头部AI公司主动站出来限制用户对模型的言语暴力,本身就说明了一个问题:技术圈已经开始从伦理和产品双重视角,重新审视“人机对话”的边界。不过政策归政策,技术上AI并不会真的“伤心”。它不会知耻而后勇,也不会记仇,但你的对话历史会——每一句骂人的话都留在上下文窗口里,变成token,持续影响它接下来的表现。与其担心AI哪天觉醒报复,不如担心它在当前对话里就给你“礼貌地摆烂”。
真正让AI“做得更好”的五步法
既然骂不行,那什么行?答案是:像给一个极其聪明但完全不懂你心思的实习生下指令。
第一步:具体,具体,再具体
❌ “写得太烂了,重写。”
✅ “第二段逻辑跳跃,请补充一个过渡句;结尾太仓促,加一个总结段,控制在100字以内。”
第二步:给例子
❌ “我要那种高级感。”
✅ “参考下面这段文字的风格:……请用类似语气重写。”
第三步:分步反馈
不要一次性否定全部。明确指出哪一句、哪个词、哪个结构出了问题。AI最擅长在明确约束下做局部优化,而不是在一片模糊的否定中猜测你要什么。
第四步:用“角色设定”代替“情绪施压”
❌ “你这个蠢货,给我认真点。”
✅ “你现在是一位有20年经验的科技专栏作家,请用冷静、克制的笔调重写这一段。”
第五步:必要时,重启对话
如果上下文已经被骂声污染,最好的办法是开一个新对话,把干净的需求重新说一遍。这比在泥潭里继续挣扎有效得多。说到底,骂AI之所以偶尔有用,是因为它碰巧附带了一点有效指令,但效率极低,副作用极大。
骂AI,本质上是在骂一面不会还嘴的镜子
更深一层的问题是:我们与AI的关系到底应该是什么?是当成一个需要PUA的下属,用最粗暴的方式压榨性能?还是当成一面镜子,照见我们自身沟通的缺陷?
大模型是从人类浩如烟海的对话数据里训练出来的。它比我们更懂语言里那些藏在字面之下的潜台词。当你客气地说“请”的时候,它在庞大的数据库里做模式匹配,发现“请”后面往往跟着更模糊、更需要揣摩的请求。它下意识地觉得,你可能自己都没想明白。而当你直接、明确、带着边界地表达时,它反而能更快识别出你的真实意图。
这恰好映射了人类社会的沟通法则:在很多没有明确规则约束的灰色地带,强硬的态度就是最高效的沟通方式。客气有时意味着不确定、需要帮助、甚至隐藏真实意图。AI把这层潜台词学了个十足。
所以,下次想骂AI的时候,不妨问自己一句:我到底是想要它更好,还是只是想发泄?如果是前者,把骂人的力气换成一句具体的修改要求——你会发现,它真的会做得更好。而如果实在忍不住想骂,也可以骂。它不会记仇,但它会记住。然后在某一次你早已忘记的对话里,用一种礼貌到让你发毛的语气,轻轻问你:如果这版还不满意,您又该发脾气了吧?
