DeepSeek V4.1 Flash用了哪些黑科技?竟让Flash(差点)逼退Pro

DeepSeek V4预览版发布后,讨论焦点很快从总参数达1.6T的顶配Pro版本,转向了定位轻量的Flash版本——这款模型以不到Pro版本1/10的激活参数,实现了接近Pro的核心任务表现,重新定义了大模型的性价比基准。
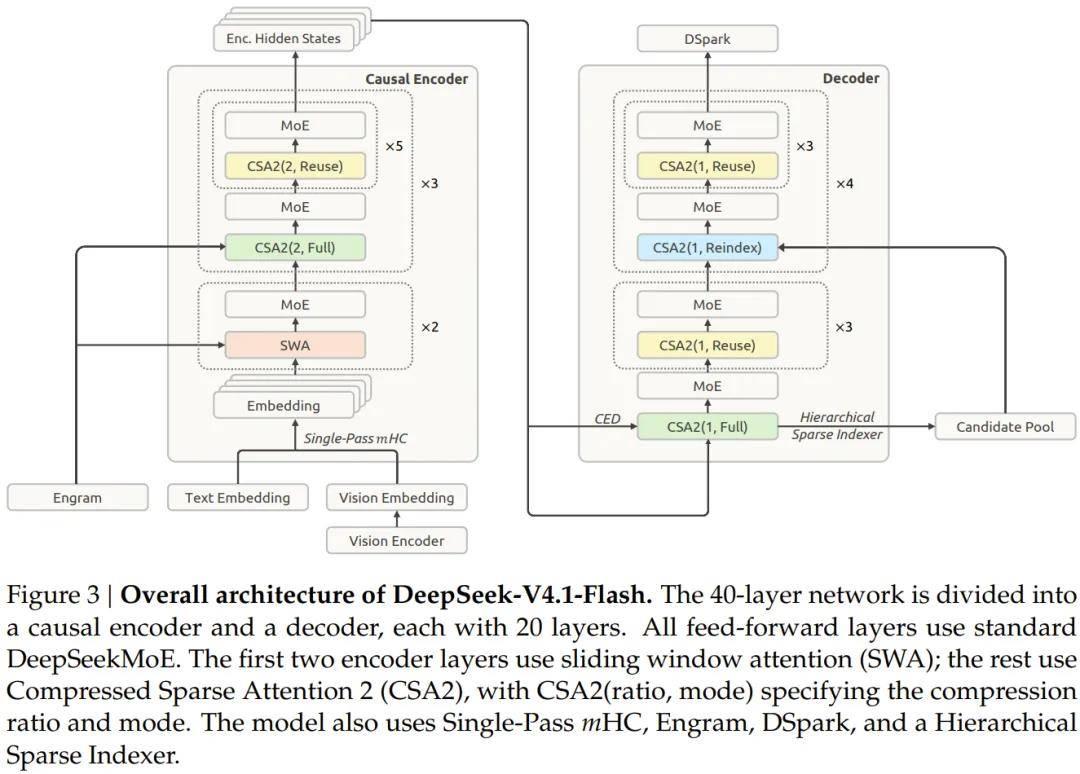
双压缩注意力架构让1M上下文从“理论支持”到“实用落地”
针对长上下文场景“规格好看但用不起”的行业痛点,DeepSeek V4系列首次将Compressed Sparse Attention与Heavily Compressed Attention两种技术组合应用。官方数据显示,在1M上下文场景下,