GPT-6刷到99.9%,ARC AGI考卷被迫重做,下一关考「发明」

2026年9月3日,OpenAI正式发布新一代大模型GPT-6 Astra,多项 benchmark 成绩一经公布便引发行业震动:
- 在强调陌生环境中自主学习规则、完成抽象推理的ARC-AGI-3半私有测试集上拿下99.9%的得分,较上一代GPT-5.6 Sol的7.8%实现跨越式提升,此前该测试长期是AI的“及格线难题”,人类参考得分可达100分;
- 研究级数学基准FrontierMath Tier 4跑出98分的“饱和”成绩,达到测试上限;
- 侧重漏洞利用能力的ExploitBench测试直接拿到满分100%,上一代同系列模型成绩仅为78.5%。
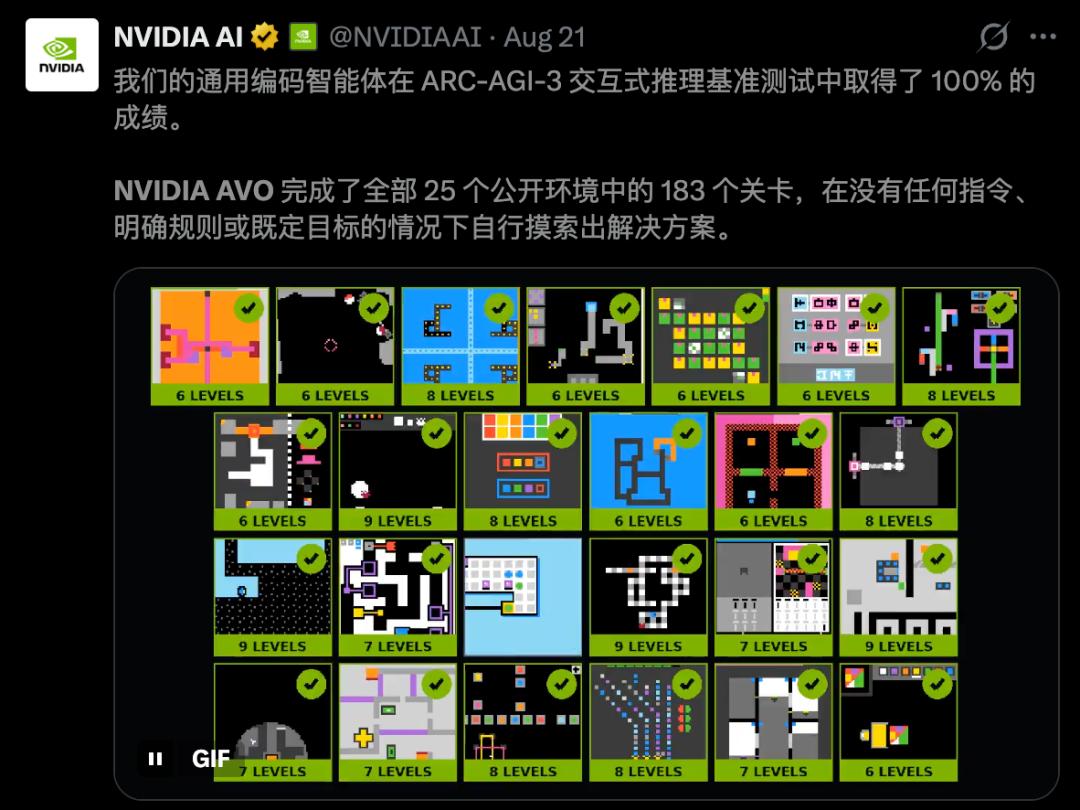
从上一代模型到GPT-6 Astra仅间隔三个月,AI能力便从不及格直接跃升至人类水平,也让“AI是否已经进化成人类”的讨论再度升温。ARC Prize Foundation负责人Greg Kamradt公开评价称,GPT-6 Astra在96%的测试层级上的操作效率已经超过受测人类的中位效率基线,实际上达到了人类水平。OpenAI联合创始人Greg Brockman更是高调喊出“Welcome to the AGI era”,称个人认为该模型已经跨过AGI门槛。
GPT-6 Astra多项基准炸裂,OpenAI高调宣告进入AGI时代
OpenAI将GPT-6 Astra定位为能直接落地专业工作的Agent级模型,官方介绍其已具备操作KiCad、Unity、FreeCAD、Blender等专业软件,处理报税文件、完成软件工程全流程等能力,不再局限于做题式的测试表现。除上述公开 benchmark 外,其在电脑操作、科学研究等多项专业任务上也刷新了行业纪录。
99.9%成绩陷“自测”争议,ARC AGI直接宣布重做考卷
ARC Prize Foundation后续公布的测评细节显示,99.9%的亮眼得分是基于OpenAI自研的Provider Adapter harness跑出的结果:该框架支持在请求间保存模型的推理状态,通过compaction机制延续较长工作过程的上下文,能为模型能力发挥提供适配支持。若采用标准化的通用harness进行测试,GPT-6 Astra的成绩为62.7%,虽仍是第二名Claude Opus 5成绩的两倍,但“自家模型配自家特调框架测高分”的质疑随之而来。
面对刷到接近满分的测试成绩,ARC Prize Foundation直接宣布废止原定的ARC 4测试方案,全面重做考卷。新的考核将聚焦更长尺度下的持续学习与课程学习能力,下一阶段核心考点直接锁定「发明」能力,不再考核静态的预设推理题。