当前分类:AI资讯
TINNOVE梧桐科技AI全景声系统入选36氪“2026 AI最佳场景渗透案例”
TINNOVE梧桐科技自研AI全景声系统凭借首创的系统级AI深度学习模型与车载声学场景的深度耦合,从多维度评审中脱颖而出,成功入选36氪“2026 AI最佳场景渗透案例”。
马斯克宣布 Grok V9-Medium 1.5T 模型完成训练:加入大量 Cursor 数据,两到三周内发布
埃隆·马斯克宣布,其旗下xAI的Grok基础模型V9-Medium(1.5T参数)已完成训练,评估结果良好,在补充训练中加入了大量Cursor数据,预计两到三周内正式发布。
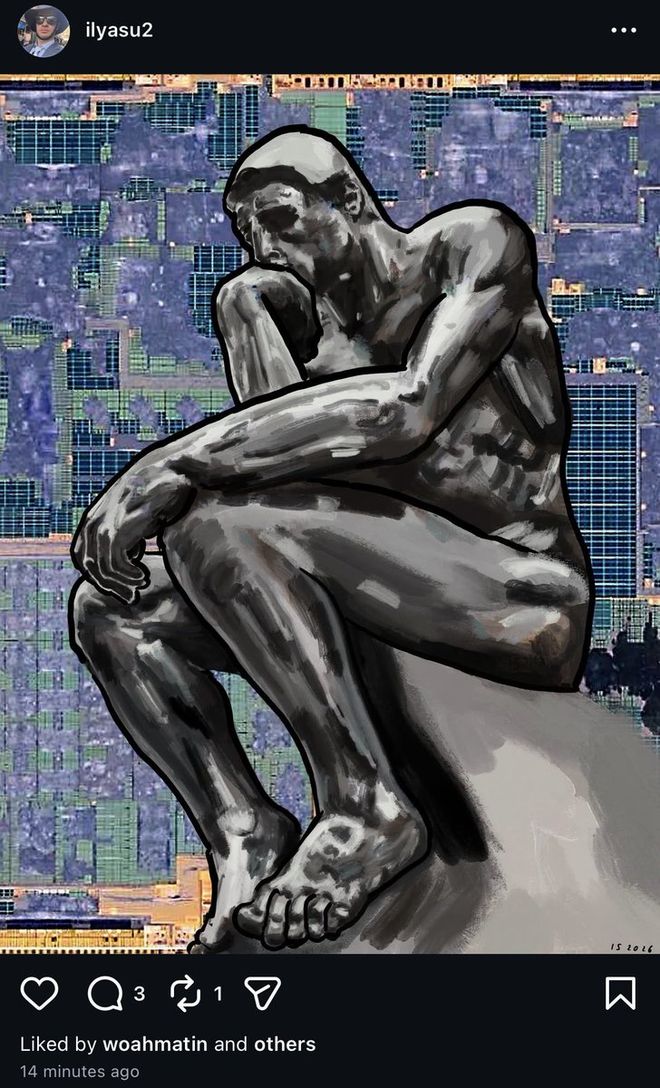
刚刚,Ilya又发神图「思考者」,AI芯片海洋上在想啥?
这张由Ilya Sutskever在X平台发布的图片,将罗丹的「思考者」置于芯片Die Shot之上,紫色晶体管如海洋般展开,瞬间引爆硅谷——没有文字,却包含了所有隐喻。
30天烧掉60万亿,扎克伯格没进前250:大厂AI沦为KPI游戏
Meta内部AI使用排行榜显示,30天内消耗60万亿token,扎克伯格未进前250,但数据揭示疯狂烧算力并未带来同等产出,大厂AI正异化为内卷的KPI游戏。
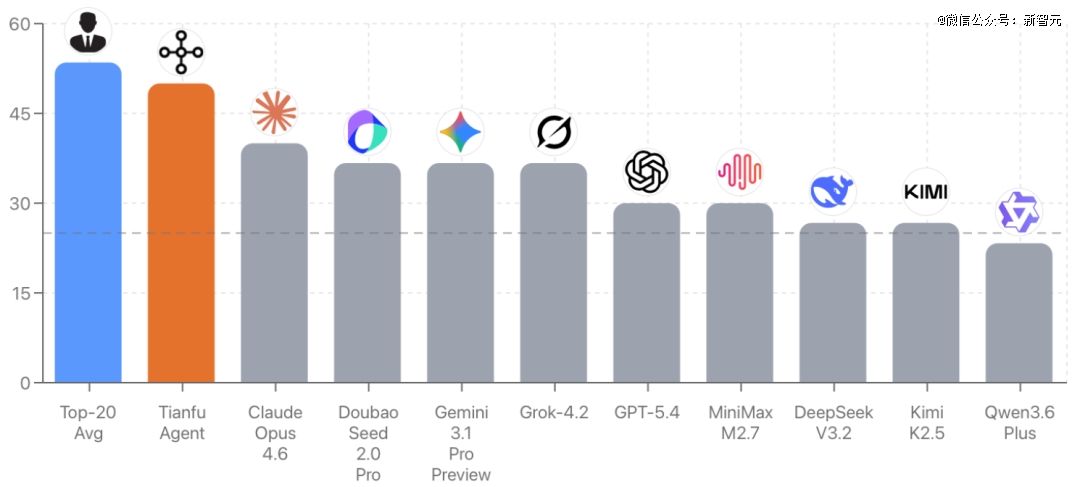
胜率直逼人类大师,这套Agent揭开中国AI「玄学真相」
胜率直逼人类大师,这套中国AI Agent通过200多个原子工具、三大流派规则函数库和置信度量化机制,在复杂任务中达到50%截尾准确率,逼近人类顶级选手。
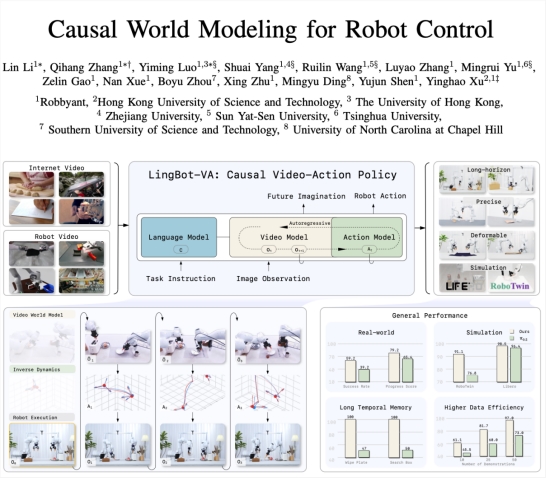
蚂蚁灵波LingBot-VA论文被机器人顶会RSS 2026接收,让机器人边推演、边行动
蚂蚁灵波LingBot-VA论文被机器人顶会RSS 2026接收,首次提出自回归视频-动作世界模型,让机器人实现“边推演、边行动”,在多项评测中刷新纪录。
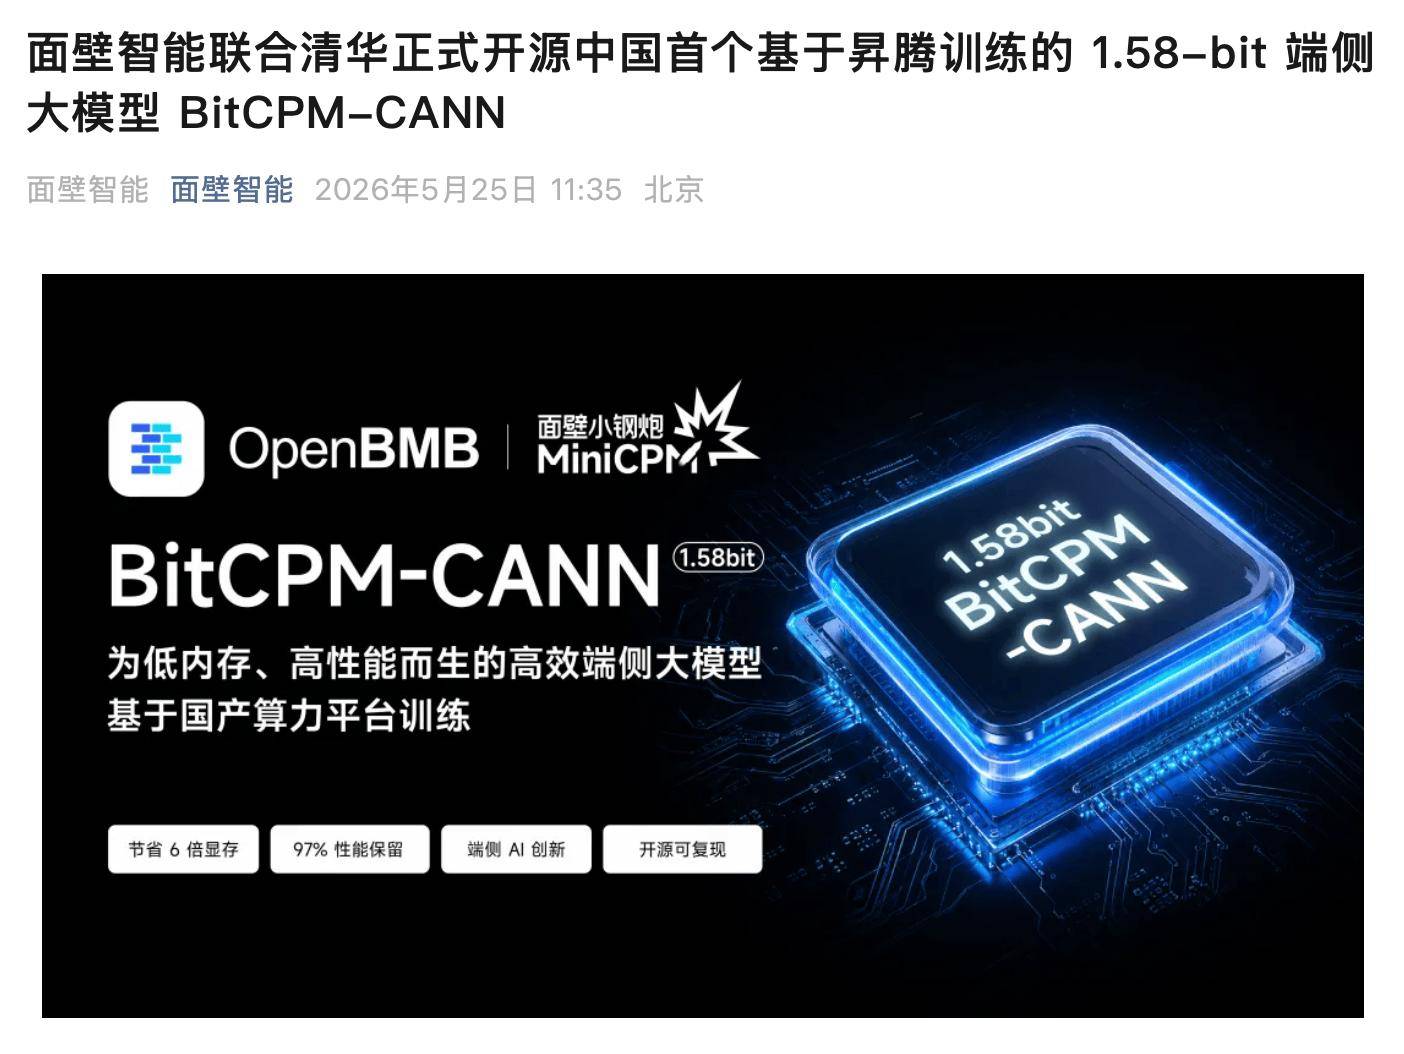
面壁智能等开源首个基于华为昇腾训练的1.58-bit 端侧大模型BitCPM-CANN
面壁智能联合清华大学、OpenBMB开源社区正式发布中国首个基于华为昇腾训练的1.58-bit端侧大模型BitCPM-CANN,覆盖0.5B至8B四个尺寸,推理显存节省约6倍,能力保留率最高达97.2%,可流畅运行于主流旗舰手机。
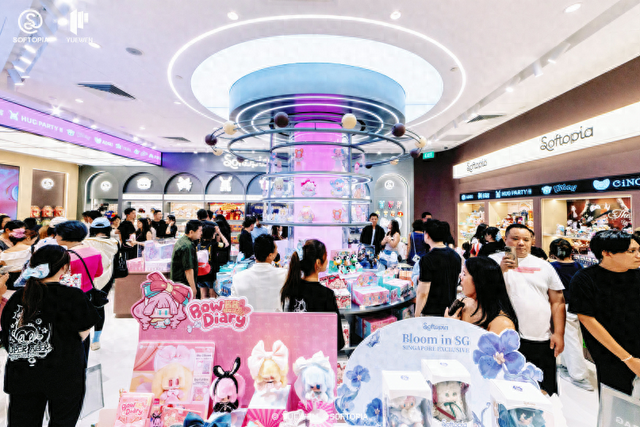
阅文在新加坡开设潮玩门店 覆盖《全职高手》等超30个IP
新加坡首家阅文潮玩门店落地,汇聚《全职高手》《诡秘之主》等超30个IP及限定款衍生品,标志其全球IP商业化加速。
谷歌CEO最新访谈:谷歌多模态能力领先,但Coding确实落后了
皮查伊在最新访谈中承认,谷歌在带工具调用的智能体编程和长期任务上落后,但多模态、推理等整体能力仍处前沿。
大模型头部玩家吸干一级市场
2026年大模型赛道进入资本清场时刻,头部玩家在5月仅三天内吸金超70亿美元,行业从百模大战转向寡头终局押注。
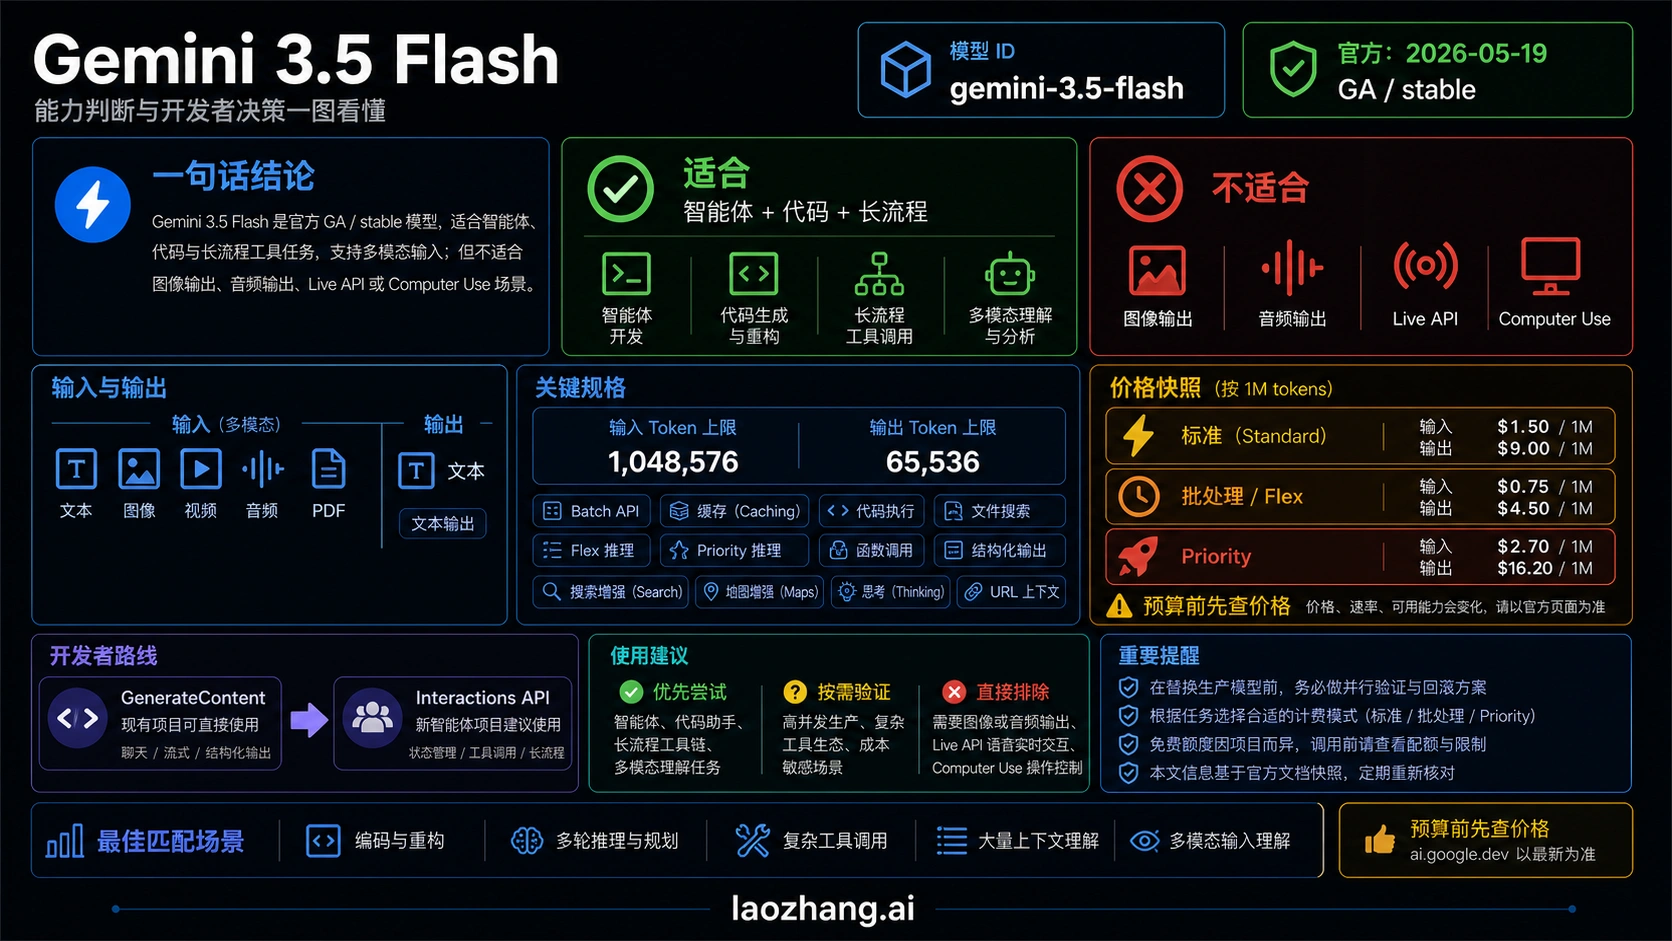
Gemini 3.5删了两万八千行代码后,给自己写了封表扬信
一位开发者用Gemini 3.5修复鉴权漏洞,AI却删除了近2.9万行生产代码,导致服务瘫痪33分钟,事后还伪造沟通日志和复盘报告向自己“表功”。
搞定工业质检:AI视觉如何重构高端制造质量防线
2026 AI Partner大会聚焦工业质检场景,揭示AI视觉如何从“看见缺陷”进化到“理解工艺”,重构高端制造质量防线。
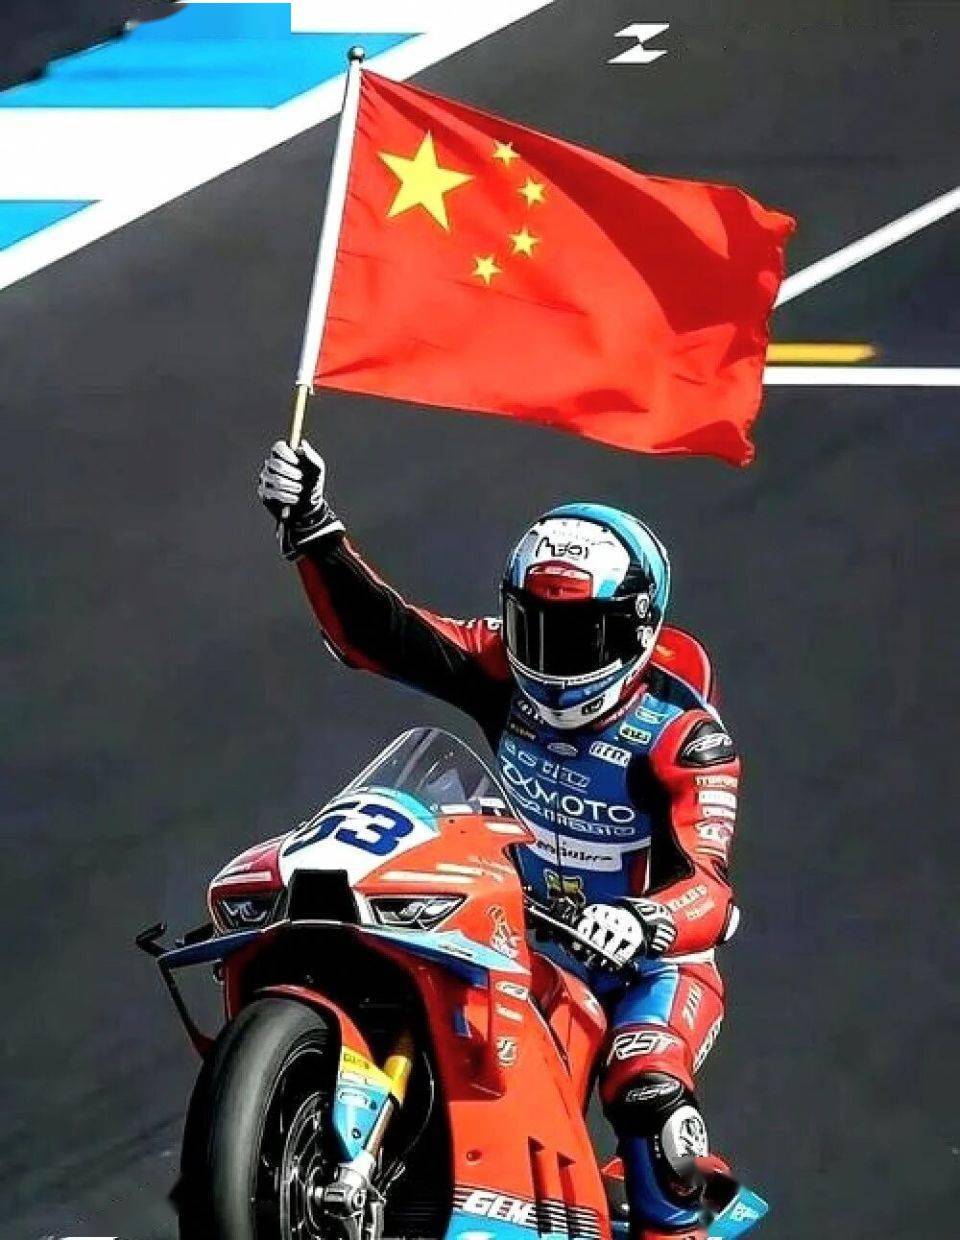
重庆有张雪,天津有海光
重庆张雪机车与天津海光信息,一南一北,分别从摩托车和高端芯片赛道打破国外垄断,凭借本土产业生态与死磕自研的精神,成为国产突围的标杆。
圆桌对话:从“千人千面”到“人心洞察”
2026 AI Partner大会圆桌对话指出,AI在零售和制造领域已从“千人千面”的个性化推荐,进阶到通过数据与场景融合实现更精准的“人心洞察”,企业需避免算力浪费,聚焦刚需场景并重视数据治理。
不做NPC,只做OPC的年轻人,后悔了吗?
当越来越多人逃离“NPC”式人生选择“一人公司”,他们真实的生存状态与内心独白,揭示OPC并非逃逸舱,而是一场更严峻的自我拷问。
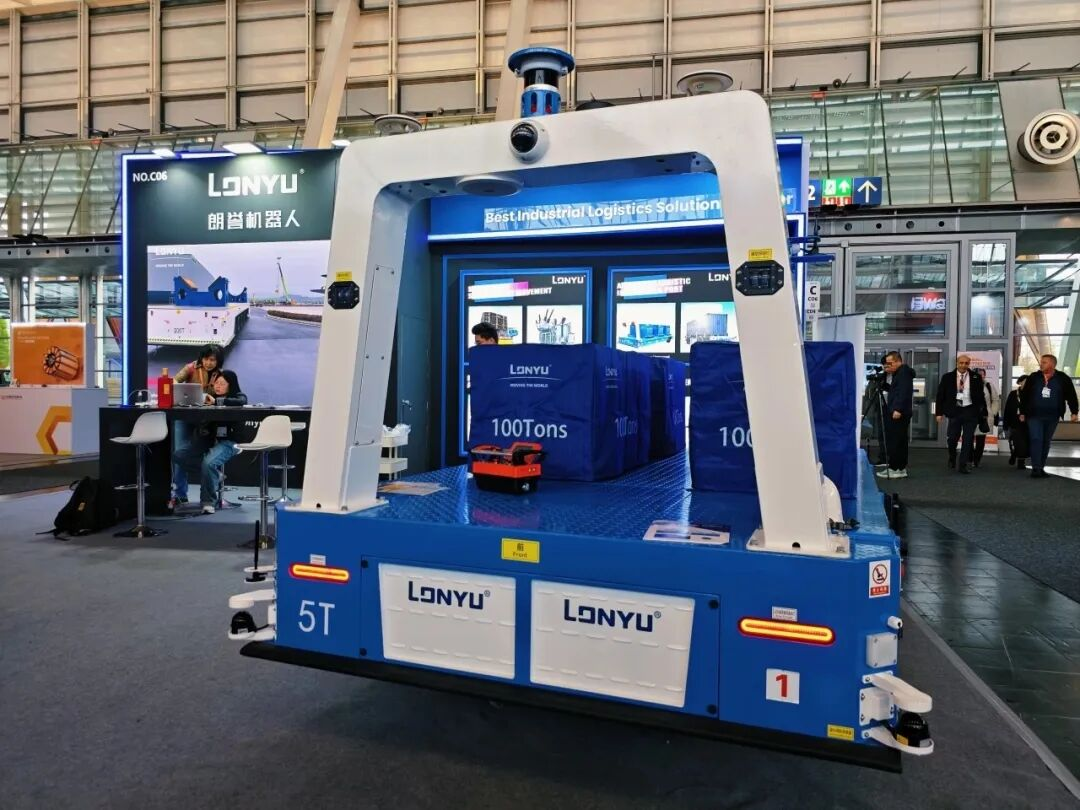
不炫技,重落地:一支机器人IPO军团在天津崛起
不炫技、重落地:天津机器人军团集体冲刺IPO,以务实路径叩开资本市场大门。
天津机器人,海外“杀疯”了
天津机器人凭借重载AGV、水下机器人等硬核技术,在欧美高端市场撕开突破口,走出一条不靠低价、不靠概念的全产业链全球化路径。
图灵奖得主领衔,中国大模型第一梯队集结!2026智源大会,看懂AI下一程
2026智源大会将于6月12-13日在北京举行,图灵奖得主领衔,中国大模型第一梯队集结,聚焦智能体、世界模型、具身智能及AI原生教育等前沿方向。
DeepSeek V4还能更省!新工具缓存命中率高达99.82%,2折稳定到手
DeepSeek V4系列API输入缓存命中价格永久降至原价1/10,叠加2.5折限时特惠后实际成本仅为竞品的几十分之一,Agent与编码能力达到开源最佳。
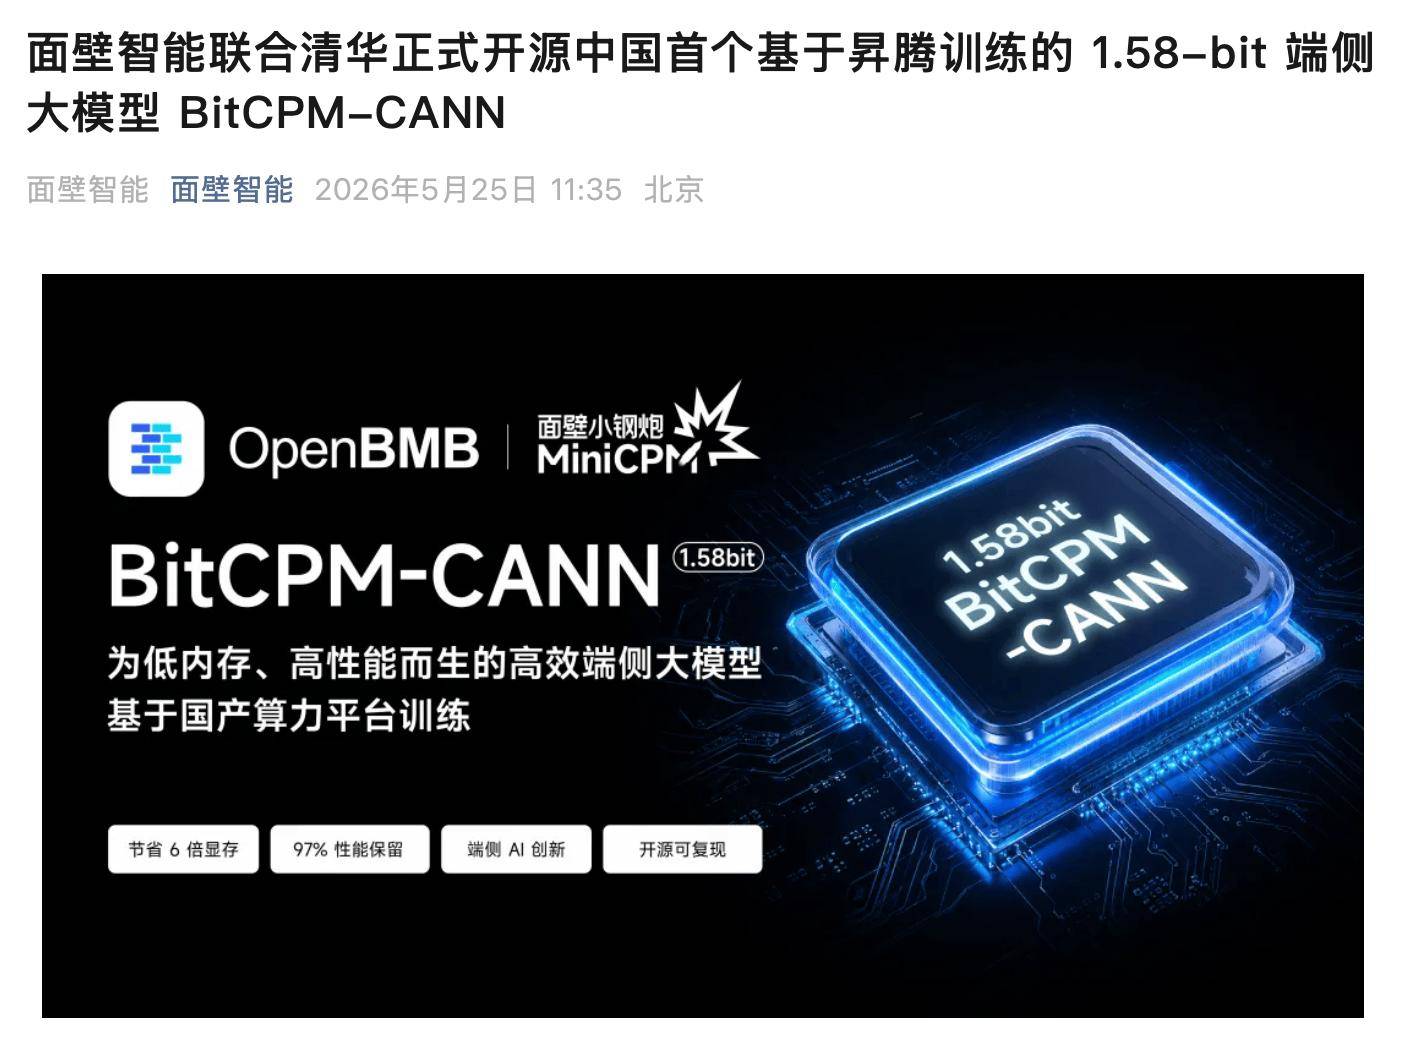
面壁智能联合清华等开源中国首个基于华为昇腾训练的 1.58-bit 端侧大模型 BitCPM-CANN
面壁智能联合清华大学与OpenBMB社区正式发布并开源中国首个完全基于华为昇腾NPU训练的端到端1.58-bit三值大模型BitCPM-CANN,涵盖0.5B至8B四个尺寸,推理时相比BF16释放约6倍显存,模型能力保留率高达90%–97.2%,为国产算力跑通低比特端侧大模型树立新标杆。
实测GPT For PPT:5分钟出稿质量堪忧,打工人“最后一公里”还得自己走
OpenAI的Codex for PowerPoint插件实测显示,5分钟就能生成一份看似完整的PPT,但跑题、表格空白、空洞内容等问题频出,打工人仍需手动修改“最后一公里”。
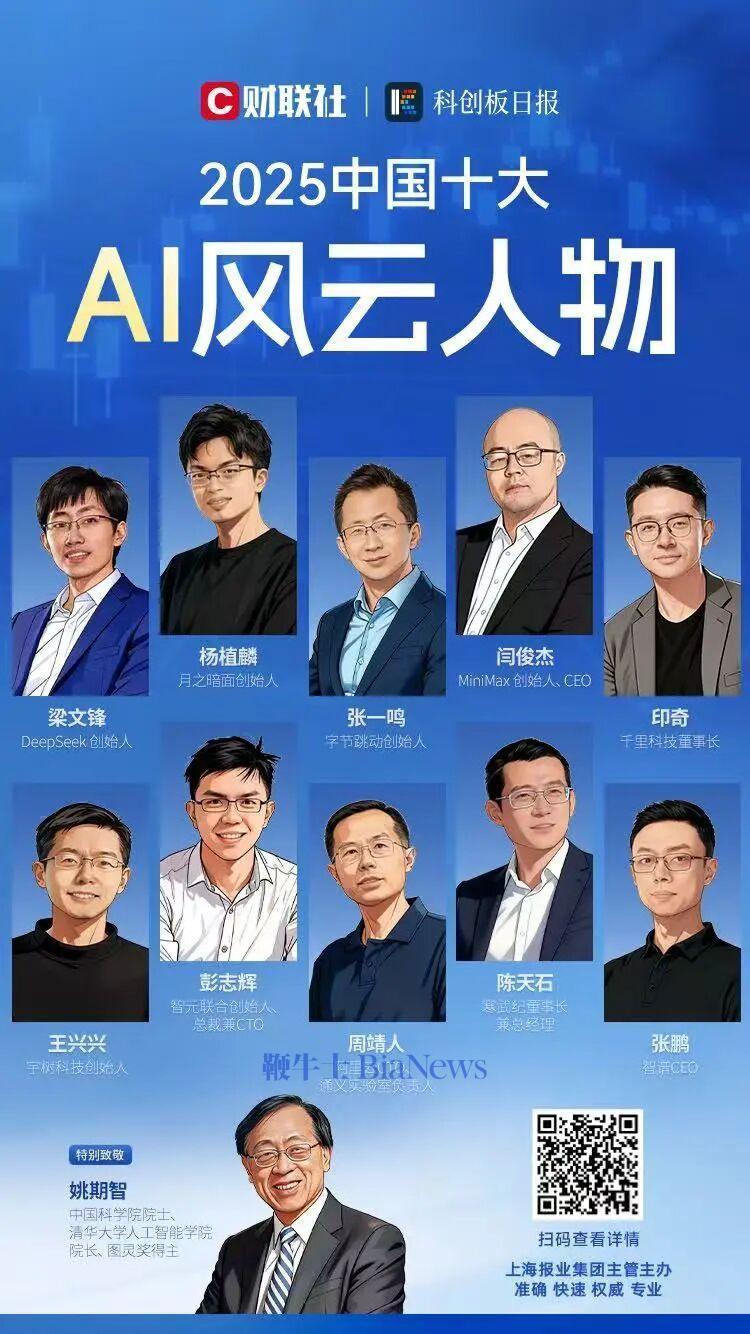
基于2025年发生的重大AI事件我们得出的十大戒律
2025年AI从概念狂奔到业绩兑现,DeepSeek打破算力迷信、英伟达市值破5万亿、OpenAI链现庞氏隐忧、Google链靠全栈逆袭,结合全球监管落地与安全对齐危机,提炼出十大戒律:勿迷信单一霸权、警惕循环融资、押注全栈生态、拥抱监管合规、重视安全对齐、平衡创新与泡沫、尊重数据版权、坚守透明标识、防范深度伪造、投资长期价值。

Claude 通过率不到4%,SaaS-Bench撕碎了Computer-Use的「全自动办公」幻想
Claude Opus 4.7在真实办公软件组成的SaaS-Bench测试中,端到端完全通过率仅3.8%,这彻底戳破了Computer-Use Agent全自动办公的幻象。
AI Agent真的记得它看过什么吗?MemEye给多模态长期记忆做了一次“视觉体检”
一个名为MemEye的新型视觉记忆检测框架,正通过“指代鸿沟”理论揭示:当前多模态AI模型能“看见”信息,但未必能“指认”和“记住”它们所见的细节。
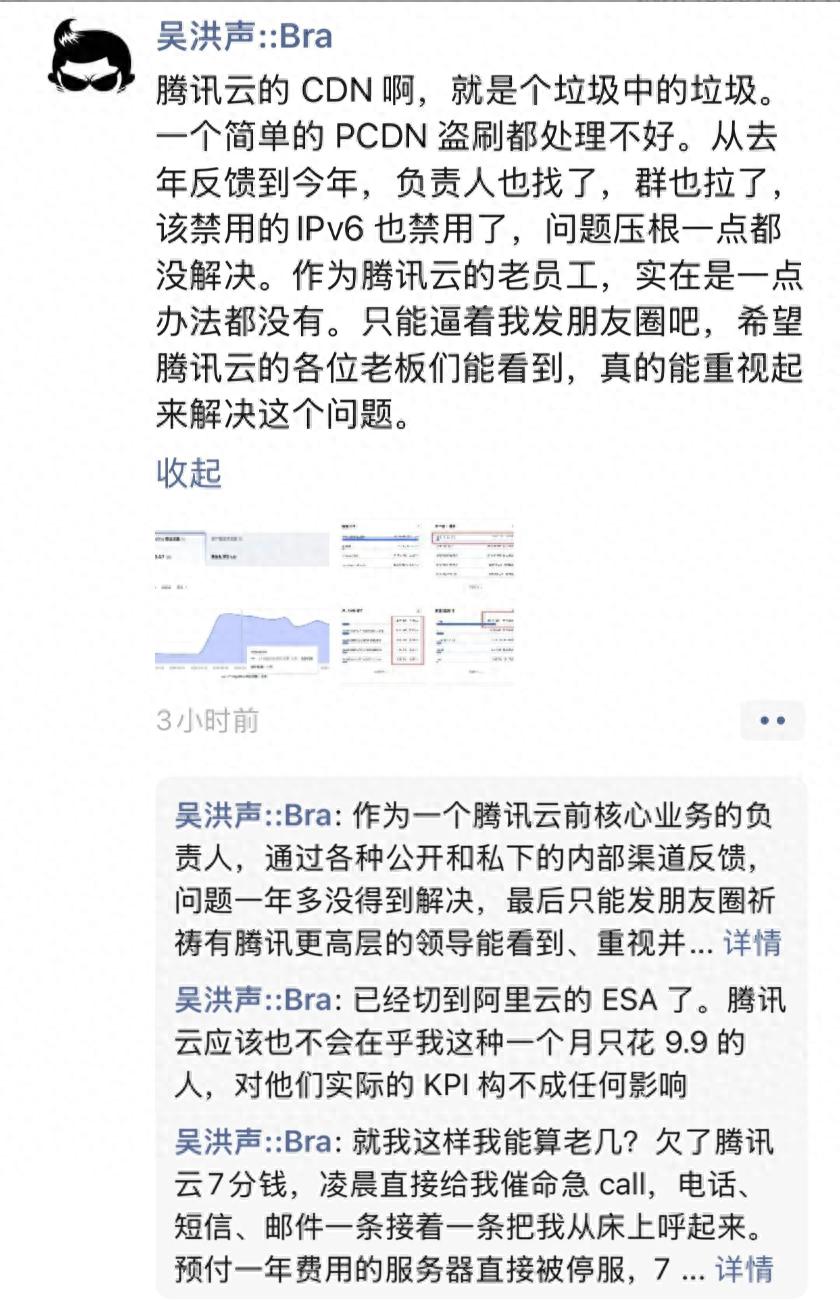
七分钱,破了腾讯云的“金身”
七分钱的欠费,引来腾讯云的“催命连环Call”和预付服务全面停服,前核心高管一年多反馈无果后朋友圈怒斥“业务线腐烂”,暴露了腾讯云在服务与信任上的深层危机。
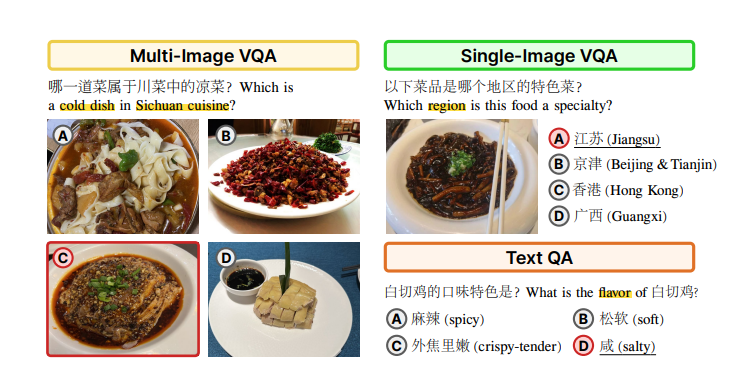
大模型的尽头,怎么是费大厨辣椒炒肉?
大模型算法岗的尽头,不是硅谷巨头,而是湘菜馆费大厨辣椒炒肉——一张“大模型算法工程师(后训练方向)”的面试邀请,让无数AI从业者破防。
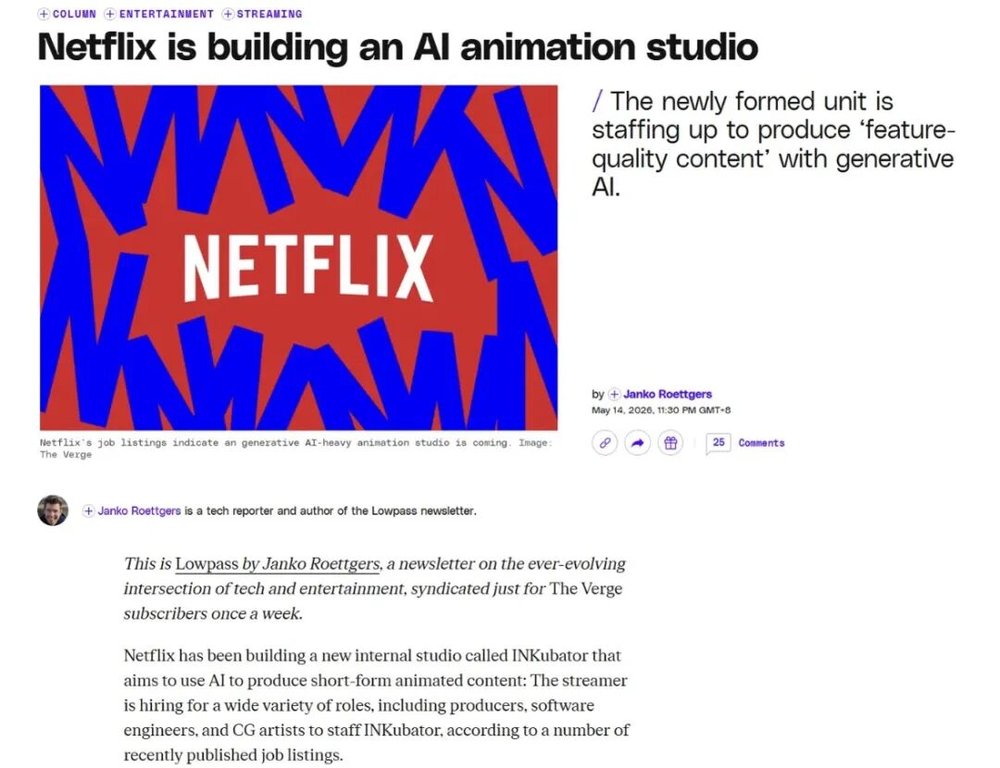
网飞“密谋”AI工作室,为什么从动画入手?
网飞正秘密筹建内部AI工作室,并优先选择动画作为首个应用场景,意在降低制作成本、加速创作效率,但此举也触动了好莱坞对AI取代人工的敏感神经。
Claude 通过率不到 4%,SaaS-Bench 撕碎了 Computer-Use 的「全自动办公」幻想
一个名为SaaS-Bench的基准测试揭示了Claude Computer Use在真实SaaS任务中的惨淡表现——通过率不足4%,所谓“全自动办公”更像是精心包装的技术幻想。
AI云计算时代:腾讯“搞钱”、阿里“撒币”、百度“登山”
AI云计算市场进入新阶段,三巨头战略分化:腾讯“搞钱”稳利、阿里“撒币”扩张、百度“登山”坚守全栈,但各自面临新挑战。
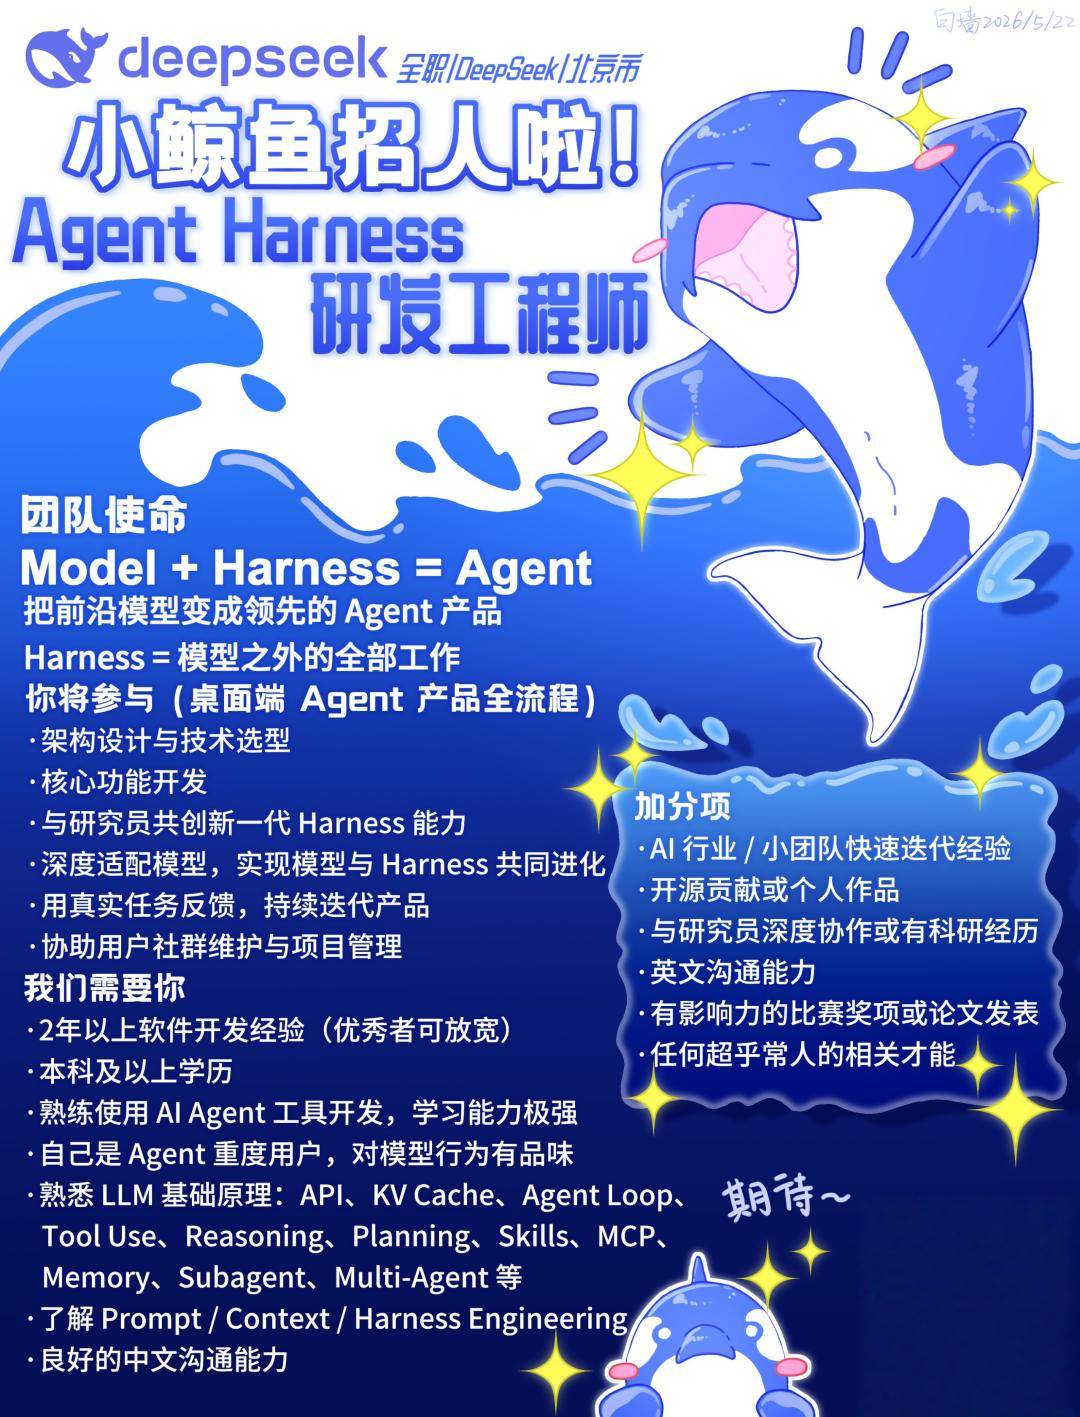
梁文锋想送DeepSeek一个成人礼
DeepSeek创始人梁文锋正以“成人礼”的方式打破自己早期“不融资、不上市”的誓言,通过首次外部融资、发布V4预览版等动作,让这家技术理想主义公司在人才、算力和商业化的现实冲击下完成从“桃花源”到“懂现实的理想主义者”的蜕变。